阿里千问发布Qwen3.8-Max:2.4万亿参数MoE大模型
阿里巴巴千问团队正式开放Qwen3.8-Max模型API服务,并宣布其开源权重将于下周发布。该模型为2.4万亿参数混合专家(MoE)架构,支持文本、图像与视频多模态输入,输出为文本;同时同步开放轻量级版本Qwen3.8-27B。官方未披露激活参数量,当前仅Qwen3.8-27B适配常规本地GPU部署。
模型发布与可用性
阿里巴巴千问团队已全面开放Qwen3.8-Max的托管API服务,并确认其开源权重将于下周发布。与此同时,另一版本Qwen3.8-27B也将同步开源权重。Qwen3.8-Max是千问家族迄今参数规模最大、能力最强的模型,总参数达2.4万亿,采用混合专家(Mixture of Experts, MoE)架构。该模型支持文本、图像和视频作为输入,统一输出文本结果。
在部署层面,托管API服务即日起面向所有规模企业开放,兼容OpenAI与DashScope接口规范,集成仅需调整基础URL和模型ID。但开源权重版本则面临显著硬件门槛——2.4万亿参数的完整检查点属于多节点数据中心级部署方案,阿里尚未公布其实际激活参数数量,因此尚无法估算推理服务成本。相比之下,Qwen3.8-27B专为普通本地GPU环境设计,是当前更现实的企业私有化部署选择。
技术规格与功能支持
Qwen3.8-Max提供100万token上下文窗口,最大输入长度为991K tokens(启用推理模式时降至983K),最大输出长度为131K tokens;最大推理预算为262K tokens。服务速率限制为每分钟200万token及1.5万次请求。定价方面:输入token为2美元/百万,输出token为6美元/百万;隐式缓存读取0.25美元/百万,显式缓存创建2.50美元/百万,显式缓存读取0.17美元/百万。缓存输入成本仅为原始输入的八分之一,意味着前缀稳定性对成本影响远大于提示词长度本身。
模型支持函数调用、结构化输出、批量请求、前缀补全及微调能力。响应API内置五项工具:code_interpreter(代码解释器)、web_search(网页搜索)、web_extractor(网页内容提取)、t2i_search(文生图检索)和i2i_search(图生图检索)。
性能表现与基准测试
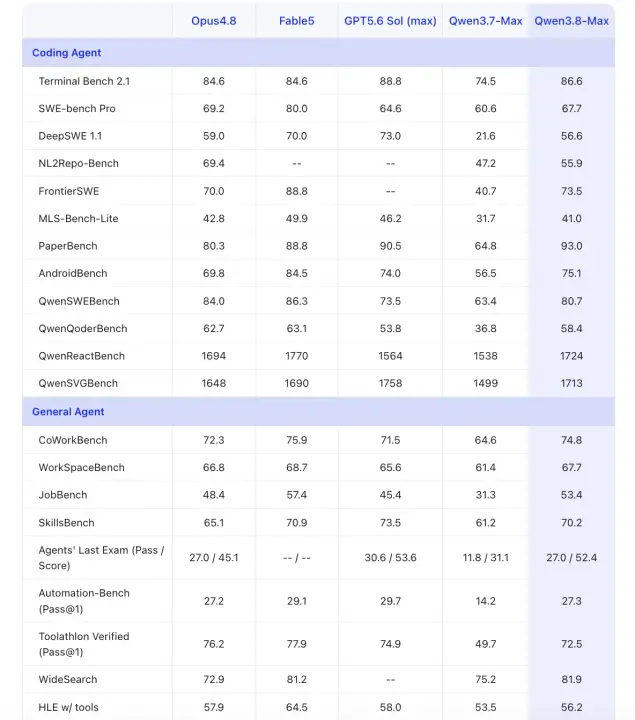
阿里随发布公布了完整评测结果。Qwen3.8-Max在Terminal-Bench 2.1中得分为86.6,略高于Claude Opus 4.8和Claude Fable 5(均为84.6),但低于GPT-5.6 Sol (max) 的88.8。在软件工程专项评测中,其SWE-bench Pro得分为67.7(Fable 5为80.0),FrontierSWE为73.5(Fable 5为88.8);但在PaperBench(93.0)和IFBench(82.8)中领先;GPQA Diamond达92.6,较前代Qwen3.7-Max(92.4)小幅提升。
多模态与智能体能力进步最为显著:在OSWorld-Verified(86.1)、Parametric CAD Bench(91.5)和OmniDocBench 1.5(92.1)等视觉任务中均居首位;相较前代提升幅度明显,如DeepSWE 1.1从21.6跃升至56.6,JobBench从31.3升至53.4。
需注意两点关键局限:其一,多模态评测对比基线为Qwen3.7-Plus而非更强的Qwen3.7-Max,可能夸大代际差距;其二,阿里自研强化学习扩展曲线在约4000个训练环境时达到峰值0.725,随后下降至0.719与0.689。
关键要点重申
Qwen3.8-Max是参数量达2.4万亿的MoE模型,具备100万token上下文,现已全面开放API服务;输入与输出token定价分别为2美元与6美元/百万,缓存输入0.25美元/百万;Qwen3.8-Max与Qwen3.8-27B的开源权重将于下周发布;目前尚未公开基准测试完整表格、许可证类型及激活参数数量;对企业用户而言,27B版本才是可行的本地化部署路径。
本文为企业智脑(优秘智能)编译整理自公开资讯,信息与观点以原文为准,仅供参考。阅读原文(MarkTechPost) →