AMD发布全开源MoE大模型Instella-MoE-16B-A3B
AMD正式发布全开源混合专家语言模型Instella-MoE-16B-A3B,总参数160亿、单次推理激活28亿,全程基于Instinct MI300X/MI325X GPU训练。模型权重采用ResearchRAIL许可(限学术研究),训练代码MIT开源,并集成Gated MLA与FarSkip-Collective两项系统级创新以提升训练与推理效率。
全栈自研:基于AMD硬件生态的开源MoE模型
AMD近日发布Instella-MoE-16B-A3B——一款从零训练、完全开源的混合专家(Mixture-of-Experts, MoE)大语言模型。该模型全部训练过程在AMD Instinct MI300X与MI325X GPU上完成,依托ROCm软件栈、Primus分布式训练框架及Miles强化学习平台,标志着AMD首次实现大模型全栈软硬协同的开源交付。
架构设计:27层解码器与动态专家路由
Instella-MoE为纯解码器架构,共27层,隐藏层维度2048,16个注意力头,词表规模128,896。每个MoE层包含2个共享专家与64个候选专家,每次前向传播动态路由其中6个专家参与计算,叠加2个共享专家,合计激活约2.8B参数(占总参数16B的17.5%)。预训练阶段采用Multi-Token Prediction目标函数。两项关键结构创新被引入:一是Gated Multi-head Latent Attention(Gated MLA),在多头潜在注意力输出端增加轻量可学习门控机制;二是FarSkip-Collective,允许将滞后或不完整激活值提前注入MoE与注意力层,实现专家并行通信与计算重叠。
训练流程:三阶段数据策略与长上下文优化
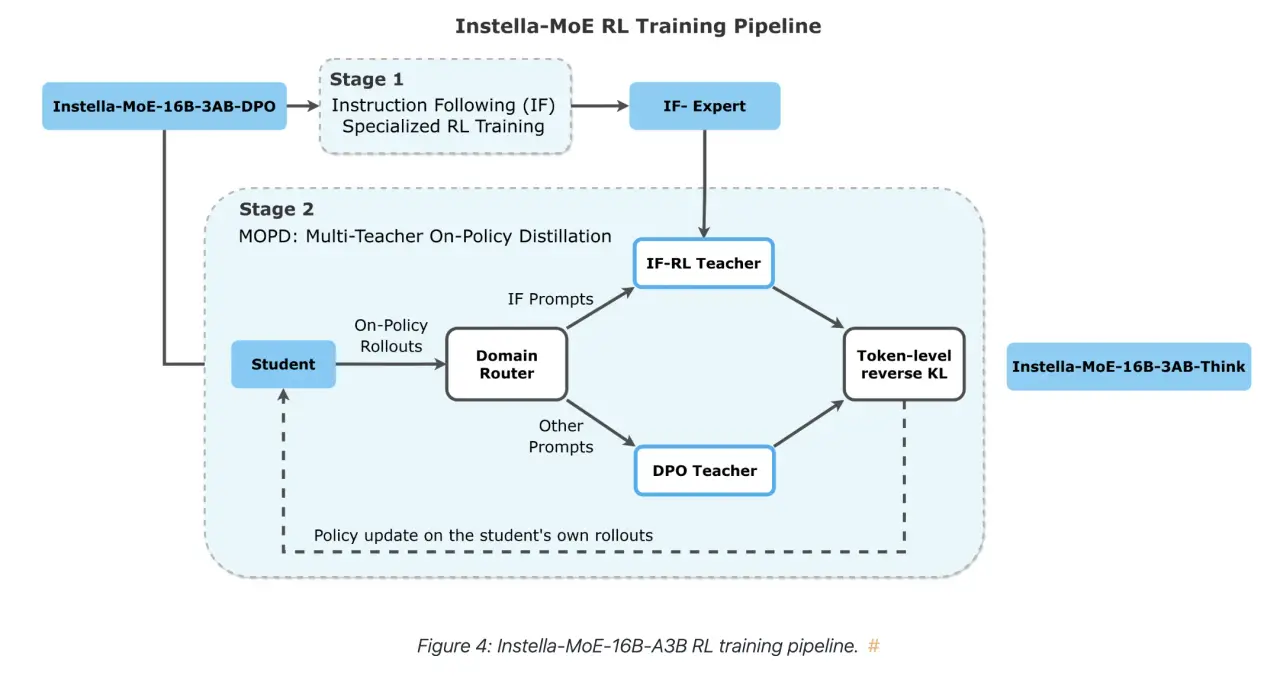
预训练阶段覆盖7.1万亿token,数据源包括Nemotron-CC-v2、MegaMath、FineMath、RefineCode及TxT360等公开语料。中期训练使用Dolma3 Dolmino 100B数据集的三个变体,通过加权平均融合。长上下文阶段将窗口从4K扩展至64K,采用YaRN方法、增大RoPE旋转位置编码的theta值,并引入文档级掩码策略。后训练阶段依次进行监督微调(SFT)、直接偏好优化(DPO)与强化学习(RL):SFT基于Dolci-Think-SFT-7B与Nemotron混合数据;DPO阶段关闭辅助负载均衡损失并更新路由器偏差,防止性能退化;RL在Miles框架下执行1400步指令跟随RLVR,再经多教师在线策略蒸馏整合能力,兼顾数学与代码能力保留。
性能表现:开源模型中综合领先
基础模型(Base)在主流评测集平均得分为76.7,位居当前所有完全开源模型首位,高于Moonlight-16B-A3B(76.2)、SmolLM3-3B-Base(70.5)等;在WinoGrande达86.5分,HumanEval+为65.7分;64K长上下文任务中,HELMET均分41.5,RULER达79.4。经Think模式后训练,综合得分升至73.22,超越Olmo3-7B-Think(71.97)与Gemma-4-E4B Think(70.47);IFEval从77.08提升至83.70。AMD报告称,Gated MLA与FarSkip-Collective联合带来12.7%预训练加速,专家并行推理下的首字延迟(TTFT)降低39.2%。
开源许可与部署适配
模型权重以ResearchRAIL许可证发布,明确限定仅用于学术与研究目的,不可直接商用。训练代码库采用MIT许可证,具备更高复用价值。推理支持SGLang框架,BF16权重内存占用约32GB,单张高显存加速卡即可部署。目标用户聚焦于AI研究实验室、高校团队及具备数据中心GPU资源的企业研发部门,不适用于依赖托管API服务的轻量级初创公司。适用场景包括MoE端到端训练流程复现、专家并行服务研究、64K长上下文行为分析及RL后训练实验。
> 编者观点:Instella-MoE的发布凸显AMD正从芯片供应商转向AI基础设施全栈参与者;其坚持“权重受限、代码开放”策略,既规避商业风险,又实质性赋能开发者生态——对中国芯片与大模型企业而言,硬件适配性验证、开源协作模式与产学研协同路径值得深入借鉴。
本文为企业智脑(优秘智能)编译整理自公开资讯,信息与观点以原文为准,仅供参考。阅读原文(MarkTechPost) →