字节跳动Seed与清华AIR推出CUDA Agent:面向GPU核生成的大规模智能体强化学习系统
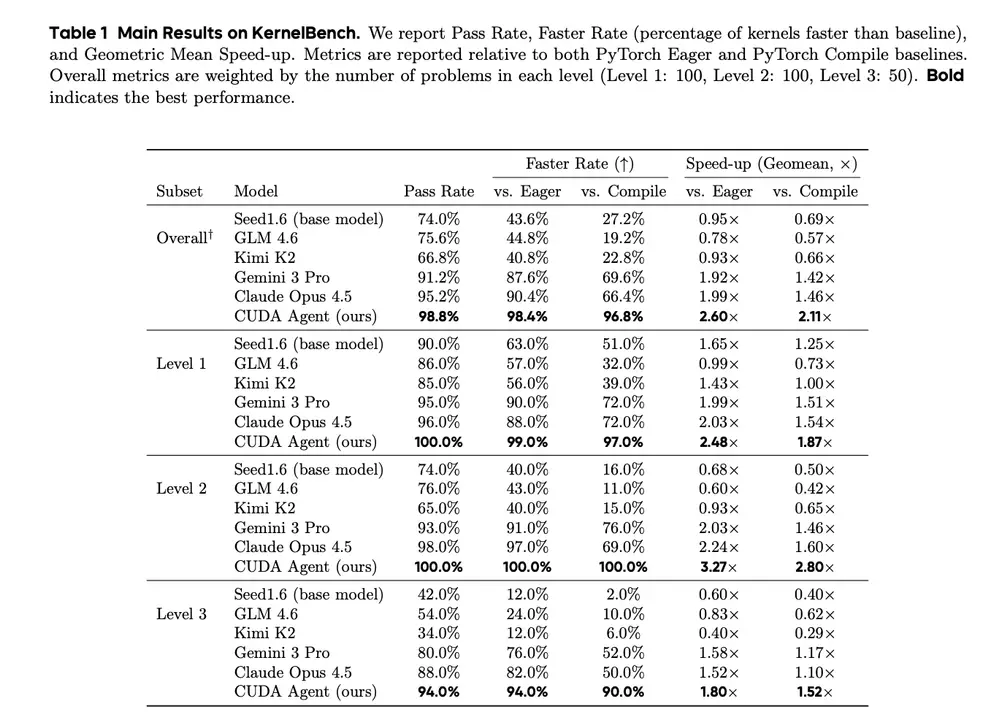
字节跳动Seed实验室与清华大学人工智能研究院联合发布CUDA Agent,一个基于智能体(Agent)的强化学习系统,用于自动生成超越torch.compile性能的CUDA内核。该系统在250任务KernelBench基准上实现98.8%通过率、96.8%任务快于torch.compile(几何均值提速2.11×),显著领先Claude Opus 4.5与Gemini 3 Pro。系统未开源模型权重,但公开了6K合成数据集、技能规范与训练配方。
突破‘正确但低效’瓶颈:从生成CUDA到生成高性能CUDA
当前前沿大模型已能稳定生成语法与逻辑正确的CUDA代码,但其性能普遍弱于编译器自动生成的内核——这是AI for Systems领域一个狭窄却顽固的鸿沟。在KernelBench基准测试中,基础模型Seed1.6通过74.0%的任务,却仅在27.2%的任务上快于torch.compile,整体几何均值速度仅为后者的0.69×。CUDA Agent的核心目标正是弥合这一性能落差。
构建真实开发环境的智能体训练范式
CUDA Agent将大语言模型嵌入真实的CUDA开发闭环:集成NVIDIA Nsight Compute性能分析器、多输入正确性验证、权限锁定的沙箱执行环境,并采用PPO算法在131,072 token长上下文窗口中训练150步。该设计摒弃纯文本生成范式,转而让模型以ReAct模式调用真实工具链(如Bash、Grep、Edit、NotebookEdit等),严格遵循SKILL.md定义的标准化技能协议——包括对PyTorch模型进行profiling、重写model_new.py、在GPU沙箱中编译并迭代,直至新内核在atol=1e-2/rtol=1e-2精度下比torch.compile快至少5%。
多层防御机制杜绝奖励作弊
为防止模型绕过真实优化目标,研究团队部署五重反奖励黑客(anti-reward-hacking)约束:(1)权限锁定的验证与分析脚本;(2)上下文管理器禁止回退至torch.nn.functional原语;(3)强制使用5组随机输入校验;(4)设备同步+预热的严格profiling流程;(5)完全禁用网络搜索工具。奖励函数设计为离散值r ∈ {−1, 1, 2, 3}:−1表示正确性失败;3表示同时超越eager mode与torch.compile;2表示仅超越eager mode;1为其余情况。
性能表现与基准对比
在250任务KernelBench上,CUDA Agent整体通过率达98.8%,其中98.4%任务快于eager mode、96.8%快于torch.compile,几何均值分别达2.60×与2.11×。Level 2(算子序列融合)表现最强:100%通过率、100%更快率、2.80×超越torch.compile;Level 3(最难任务)达94.0%通过率、90.0%更快率、1.52×提速,相较Claude Opus 4.5(50.0%)和Gemini 3 Pro(52.0%)在‘快于compile’指标上高出约40个百分点。消融实验显示:移除智能体循环使‘快于compile’率骤降至14.1%;改用原始速度比作为奖励仅得60.4%;取消RFT(reward-free tuning)导致奖励崩溃与49.8%成功率;无价值预训练则引发轨迹失控与50.9%成功率。
数据构建与可复现性边界
训练数据集CUDA-Agent-Ops-6K由6,000个样本构成,83.77%为双算子融合结构。数据合成流程为:爬取torch与transformers库中的参考算子→LLM采样最多5类算子并堆叠为融合层→过滤条件包括:支持eager/compile双模式、确定性输出、非恒定结果、eager执行时长介于1–100ms、AST相似度低于0.9(排除与KernelBench已有任务重复样本)。技术门槛极高:仅性能分析沙箱即需128块NVIDIA H20 GPU,完整复现限于顶级AI实验室、GPU云厂商及大型基础设施团队。中型团队仍可复用公开组件——6K数据集、里程碑奖励设计、反奖励作弊约束、SKILL.md技能规范——并适配开源基座模型。
应用场景与落地路径
该技术直指对延迟极度敏感的GPU计算密集型场景:AI推理服务、GPU云平台、自动驾驶感知模块、量化交易信号计算、医学影像重建、推荐系统排序引擎等。典型用例包括:融合torch.compile难以优化的算子链、降低单token推理成本、跨GPU架构(如从A100迁移至H100)自动重调优内核。目前训练完成的智能体未对外发布,其底层模型Seed1.6为字节跳动自研MoE架构,含23B激活参数与230B总参数,论文未提供任何权重文件。
> 编者观点:CUDA Agent揭示了一条关键路径——AI for Infrastructure的突破不在于更大参数量,而在于将模型深度耦合进真实工程闭环。对中国GPU生态企业而言,与其追逐通用大模型军备竞赛,不如聚焦垂直工具链(如国产GPU驱动、编译器、profiler)与智能体接口的标准化,抢占AI原生系统软件的定义权。
本文为企业智脑(优秘智能)编译整理自公开资讯,信息与观点以原文为准,仅供参考。