Cursor开源MoK:面向GB300 NVL72机架的确定性MoE训练巨核
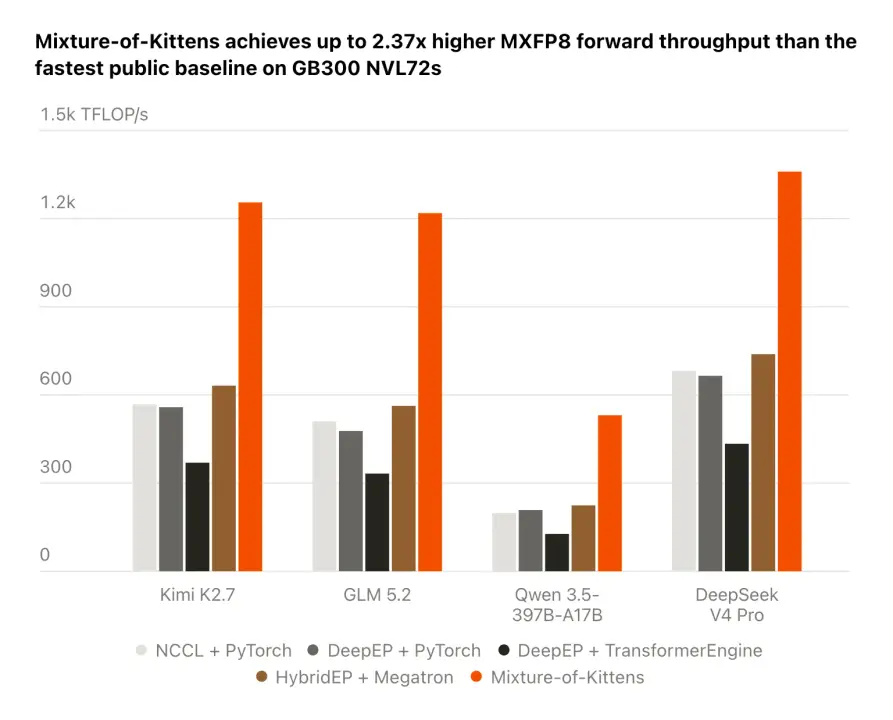
Cursor Research正式开源Mixture-of-Kittens(MoK),一款专为NVIDIA GB300 NVL72机架优化的混合专家(MoE)训练巨核。该内核将全部通信与计算步骤融合为单个确定性内核,实测相较最强公开基线最高提速2.37倍,并已在数万GPU规模的Composer模型训练中落地。其部署需Blackwell架构SM100/SM103 GPU及配套软硬件栈。
专为NVL72机架设计的确定性MoE训练巨核
Cursor Research近日开源Mixture-of-Kittens(MoK),即支撑其Composer系列大模型训练的核心混合专家(MoE)训练巨核。MoK并非传统模块化实现,而是将MoE前向路由、专家计算、结果聚合及反向传播中的全部通信与计算操作——包括跨GPU张量分发、专家本地GEMM、激活组合、梯度反传与路由器权重更新——完全融合进一个端到端确定性的CUDA内核中。团队称,该设计在GB300 NVL72机架(单机架72块GPU,全NVLink互连域)上实现了极致的硬件协同效率,实测最高达2.37倍吞吐提升,并已实际支撑Composer模型在数万个GPU上的规模化预训练与后训练。
硬件与生态门槛明确:仅适配前沿Blackwell基础设施
MoK当前仅支持NVIDIA Blackwell架构的SM100或SM103流式多处理器,即必须运行于GB200或GB300 NVL72机架之上。软件依赖亦严格:需Python 3.12+、PyTorch 2.10+及CUDA Toolkit 13.0+;跨GPU缓冲区依赖PyTorch对称内存(symmetric memory)特性。这意味着实际可部署方仅限于拥有或租用NVL72算力资源的组织,包括前沿AI实验室、获得重资支持的大模型初创公司、新兴GPU云服务商(GPU neoclouds)及国家级超算中心。单节点团队或8卡小集群不具备运行条件。
三大关键技术决策:拉取调度、中粒度重叠与环形令牌缓冲
MoK针对GB300 NVL72的硬件特性做出三项关键设计:
1. 拉取式前向调度 + 推送式前向聚合:针对专家负载不均衡场景,MoK摒弃主流的推送(push-based)通信范式(如DeepEP),转而采用拉取(pull-based)前向调度。微基准测试显示,拉取方式可使NVLink反向通道带宽利用率提升29%,并消除跨GPU完成信号开销——调度信号延迟从103微秒降至18微秒(5.8倍优化)。反向传播则镜像采用拉取式反向聚合与推送式反向调度,四类操作共用一张调度表,开销低于MoE整体运行时间的3%。
2. 工作负载自适应的中粒度计算-通信重叠:MoK未采用极细粒度(如Comet)或极粗粒度(如DeepEP)策略,而是提出“中粒度”重叠启发式:确保每个专家分组GEMM至少覆盖两个完整的SM波(warp wave)。以Composer 2.5基础模型Kimi 2.5为例,其最小有效token数为2,368,实测延迟与此估算高度吻合。
3. CPU无关的环形令牌缓冲:为规避CPU-GPU同步瓶颈(GB300中Grace CPU相对GPU性能较弱),MoK引入固定大小的数百MB环形令牌缓冲区,按minibatch粒度循环复用,并在macrobatch边界交错执行dispatch与combine。环形缓冲按逆序遍历,以最小化反向传播时的前向激活重放开销。
性能实测:从单机架到跨机架端到端验证
在单GB300 NVL72机架(专家并行度64)、每GPU承载2048 tokens的配置下,MoK在Kimi K2.7 Code、GLM-5.2、Qwen3.5-397B-A17B及DeepSeek-V4-Pro等模型结构上展开测试。对比基线包括NCCL+PyTorch、DeepEP+PyTorch、DeepEP+TransformerEngine及HybridEP+Megatron。结果显示:MXFP8精度下,MoK前向速度达最快基线的2.37倍,反向为1.78倍;BF16精度下,前向与反向分别提速1.92倍与1.58倍。在512 GPU(跨多个GB300 NVL72机架)的端到端训练中,每GPU token/s从760.9提升至1070.2,整体加速1.41倍。
开源与适用场景
MoK以Apache-2.0许可证发布于GitHub,支持BF16与MXFP8双精度模式;其调度经由Blackwell集群启动控制(Cluster Launch Control)实现,不阻塞跨机架RDMA通信;路由器权重梯度计算采用SonicMoE风格,与SwiGLU反向传播深度融合。当前主要适用场景聚焦高价值窄域任务:DeepSeek-V3类MoE模型的预训练与后训练、on-policy强化学习的后训练阶段,以及模型内部消融研究。
编者观点:MoK代表了大模型训练基础设施向“硬件-算法-编译器”深度协同演进的关键一步,对中国头部AI企业及智算中心建设具有直接参考价值——在Blackwell时代,仅靠堆叠GPU已不足以释放算力,必须通过定制化巨核重构软硬协同范式。