谷歌AI推出EnvHarness:可编程环境适配层
谷歌云AI研究院联合多所高校推出EnvHarness,一种不修改底层模拟器、仅通过标准接口动态重塑静态评测环境的可编程层。它利用自动编写的插件组件(如Stage、Contract、Chain)实时适配LLM智能体训练需求,在5个基准测试中提升泛化性能最高达9.0分,执行步数减少9.8%。项目已开源,Apache-2.0许可。
静态环境的瓶颈与新范式
当前LLM智能体正从依赖预设文本转向依赖交互式环境学习,但主流评测环境(如ALFWorld、WebArena)普遍为人工构建、行为固定——无论智能体能力如何演进,环境响应始终如一。这导致两个根本缺陷:无法聚焦策略弱点进行针对性训练;一旦任务被攻克,环境即丧失教学价值。传统应对方案是生成新环境,但该路径存在显著成本:领域专用生成流水线难以迁移,且依赖LLM自动生成的验证器需大量过采样与人工过滤,可信度存疑。
EnvHarness:以‘包装’替代‘重建’
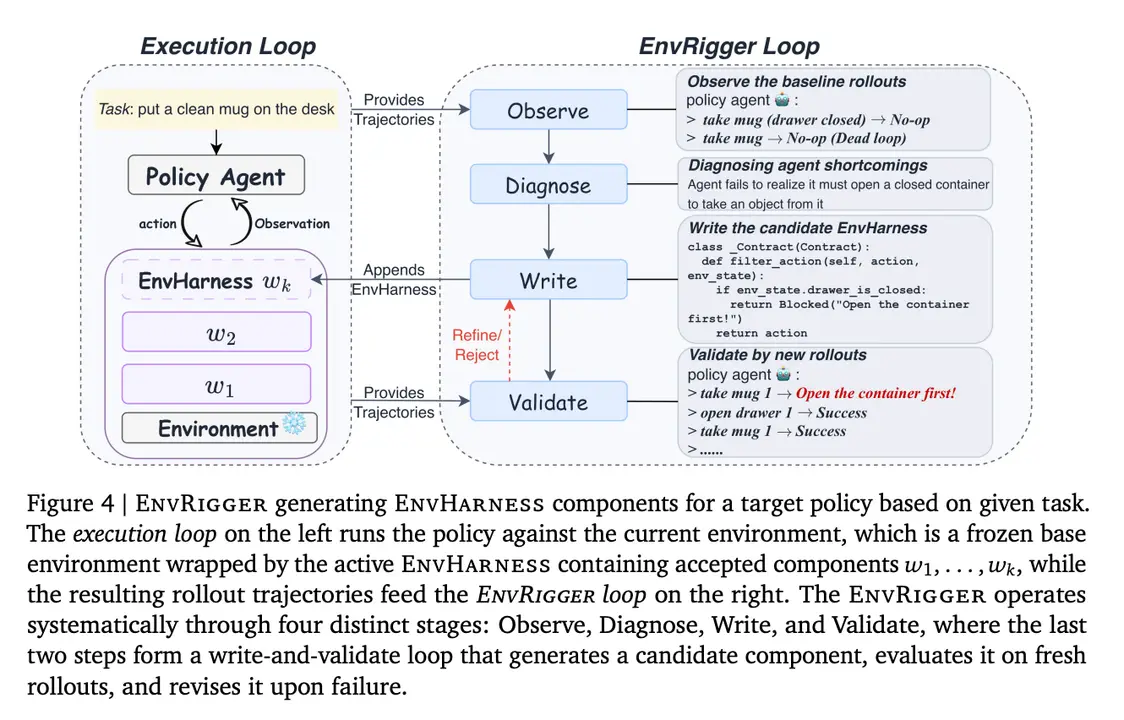
研究团队提出反向思路——不重写环境,而为其‘加装’可编程外壳。EnvHarness作为轻量级Python层,严格封装于标准`reset()`/`step()`接口之上,通过插件化组件动态调控episode起点、可用动作空间及观测内容,同时完全保留原始模拟器、任务定义与人工编写的验证逻辑。其核心设计哲学是:环境本身冻结,适配能力外置。
三大可组合组件
EnvHarness默认提供三个正交组件,支持自由组合:
- Stage:在`reset()`后重放预设动作序列,强制episode从非初始状态启动(例如将目标杯子隐藏于关闭抽屉中,迫使智能体执行搜索而非直接抓取);
- Contract:在每步中对动作、状态转移或观测施加细粒度干预(如屏蔽危险动作、重写错误响应、截断冗余观测);
- Chain:在单episode内串联第二个环境,共享步数预算,最终判定结果为两个环境验证器的逻辑与(conjunction)。
EnvRigger:自动化组件设计师
EnvRigger是配套的策略驱动型设计循环。它将待优化智能体视为黑盒,执行四阶段闭环:1)采集5次基线rollout;2)诊断系统性缺陷(如反复失败于特定子任务);3)自动生成符合Python语法的组件代码;4)在5次新rollout上验证效果。拒绝不可解或过于简单的候选任务,最多迭代5轮;所有生成代码在隔离子进程中编译执行,确保错误仅记录为trace而非导致训练中断。
实证效果与工程就绪性
在ALFWorld、WebArena、SWE-bench Verified、OfficeQA和SpreadsheetBench五大基准上,经EnvHarness重塑环境训练出的技能,在未见过的held-out任务上全面超越对照组。ALFWorld平均得分从62.4升至68.3,分布外(out-of-distribution)任务提升达9.0分;SWE-bench Verified解决率由49.88%→52.58%,平均执行步数从55.01降至49.61(降幅9.8%)。值得注意的是,在SpreadsheetBench和WebArena中,未经重塑的环境甚至导致技能表现低于‘无技能’基线——凸显环境适配的必要性。相比领域专用生成器SWE-smith,EnvHarness在SWE-bench上高出2.46分且少用5.11步。项目已开源(Apache-2.0),含6个环境复现脚本;新环境仅需实现7个标准方法(`reset`/`step`/`observe`/`evaluate`/`get_env_state`/`save_state`/`from_state`),下游代码零修改。硬性前提仅为环境需支持重置(排除真实用户账号与物理机器人场景)。
编者观点
EnvHarness揭示了一条被忽视的AI训练基础设施创新路径:与其不断‘造新环境’,不如赋予旧环境动态进化能力。对中国AI企业而言,这意味着可低成本升级现有评测体系,尤其利好已在复杂业务场景部署静态仿真环境(如金融风控沙箱、工业数字孪生)的团队,无需推倒重来即可构建持续进化的智能体训练闭环。
本文为企业智脑(优秘智能)编译整理自公开资讯,信息与观点以原文为准,仅供参考。阅读原文(MarkTechPost) →