企业级具身智能体落地的五大系统性原则
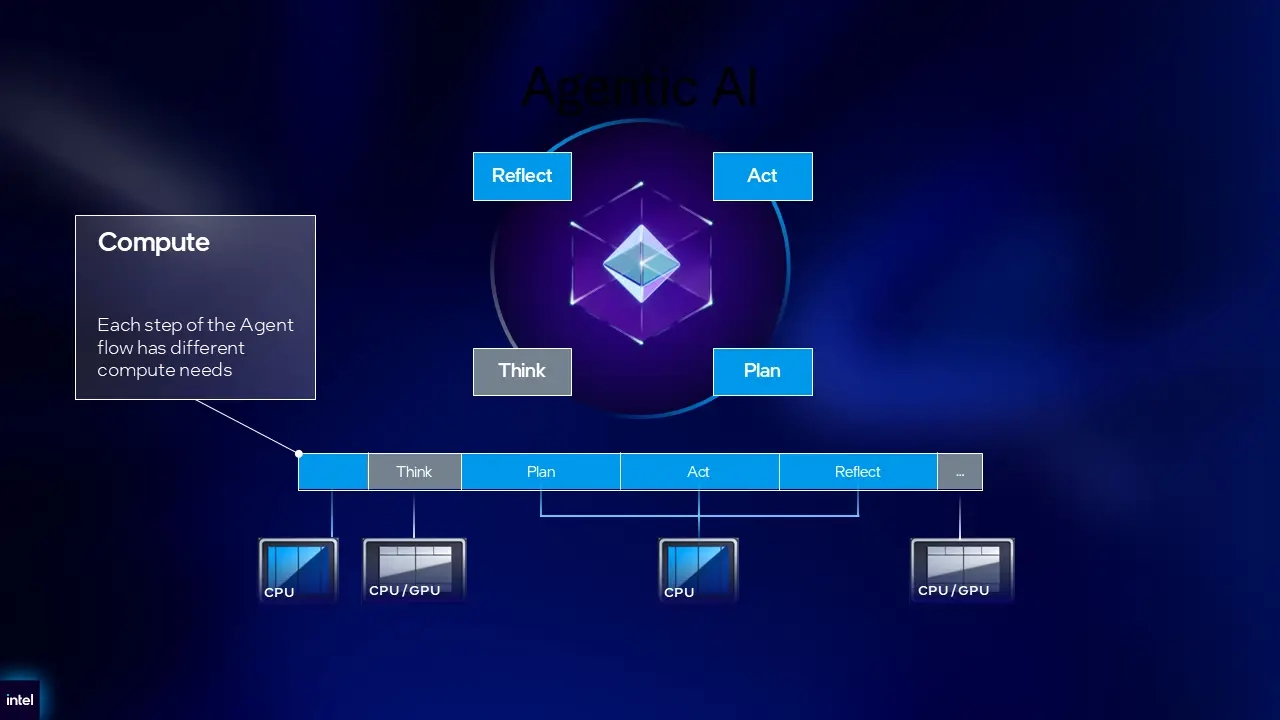
英特尔通过数千次具身智能体(Agentic AI)工作负载实验,提出五大实践准则:智能体是系统工程而非单纯推理问题;需以每虚拟CPU承载智能体数(agent density)为容量规划核心;应监控任务P95延迟而非平均CPU利用率;默认采用横向扩展(scale-out);需构建面向工作流全链路的可观测性体系。
智能体即端到端业务工作流
对企业而言,具身智能体的价值远超升级版聊天机器人。它指能跨人员、业务流程、数据与系统全自动执行端到端商业任务的软件智能体。支撑此类智能体运行的理想平台,必须具备充足的CPU算力、高韧性数据访问能力、策略感知型工具调用机制、全链路可观测性、内存管理能力,以及可预测的智能体编排与弹性伸缩能力。
五大实证性工程原则
为厘清关键依赖关系,英特尔开展了数千次具身智能体工作负载实验,提炼出五条企业级落地原则: 1. 具身智能体本质是系统问题,而非仅推理问题:其企业价值取决于完整系统栈——任务编排、数据接入、工具执行、延迟控制、治理机制与可扩展基础设施; 2. 现有评估框架存在局限:多数当前工具仅聚焦LLM本身性能,未衡量整体系统吞吐、稳定性与成本效率; 3. 容量规划应基于智能体密度(agents per vCPU),而非智能体绝对数量; 4. 监控重点应是任务延迟(P95),而非平均CPU利用率:因智能体行为呈“脉冲式”(bursty),平均利用率易掩盖排队瓶颈; 5. 默认优先横向扩展(scale-out):纵向扩展(scale-up)仅适用于单智能体计算负载极重或存在架构约束的特例。
六维企业级效能指标
企业AI运维者真正关心的是:系统是否按预期运行?最大可持续智能体数量是多少?如何科学扩容?为此,需超越LLM评测,建立六维指标体系:任务成功率、单任务成本、单任务耗时、任务吞吐量、智能体密度(agents/vCPU)、端到端延迟。这些指标共同构成评估平台健康度与商业可行性的基础。
基于Terminal-Bench的深度基准测试
英特尔扩展开源基准工具Terminal-Bench,加入性能剖析、遥测与确定性回放功能。通过录制并固定LLM响应(消除模型波动干扰),精准分离智能体逻辑层与模型层开销。测试任务集覆盖编译、数据库操作、布尔逻辑、光线追踪、视频转码、机器学习训练等10类典型企业负载,确保结论具备广泛适用性。
三维部署方法论
具身智能体落地需分三阶段推进:
- 容量规划维度:以智能体密度(agents/vCPU)为标尺,实现跨实例规格与处理器代际的容量可比性;交互型助手宜低密度保障响应时效,批处理类IT工作流可接受更高密度;
- 可观测性维度:摒弃平均CPU利用率这一弱信号,转向P95任务延迟作为首要告警指标,可在平均耗时明显恶化前识别排队风险;
- 弹性扩展维度:实证表明scale-out在绝大多数场景下更优——新增节点提升总容量,而scale-up仅用于单智能体计算峰值极高或受硬件架构限制的边缘情况。
本文为企业智脑(优秘智能)编译整理自公开资讯,信息与观点以原文为准,仅供参考。阅读原文(MIT科技评论) →