Meta发布Muse Code Beta:终端编程智能体搭载Muse Spark 1.2模型
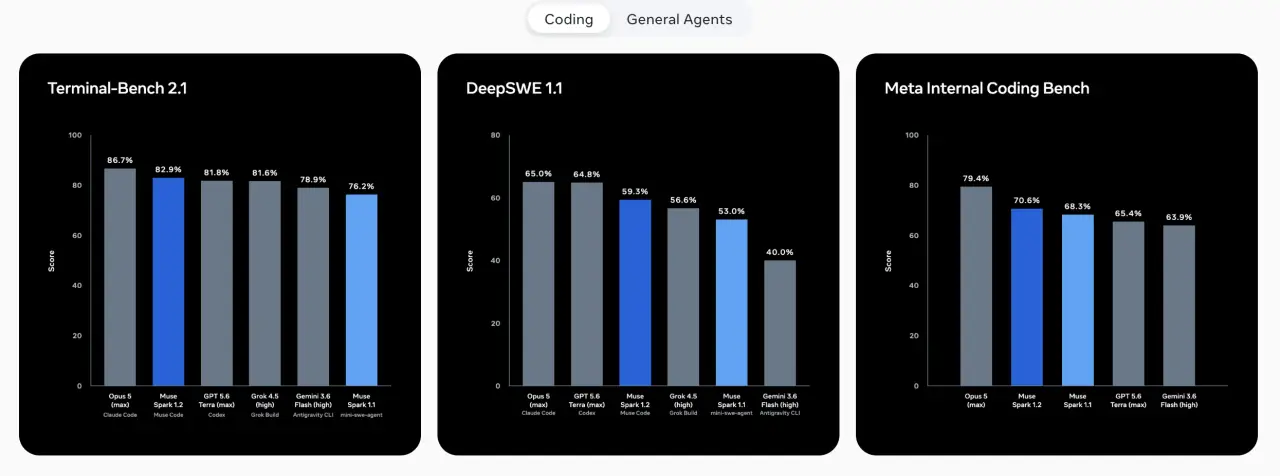
Meta AI正式推出终端编程智能体Muse Code(Beta版),由新发布的编码专用大模型Muse Spark 1.2驱动。该系统支持跨大型代码库的复杂工程任务,具备异步后台智能体、本地事件日志回放重启机制及三大内置技能。模型通过与执行框架联合训练、长周期任务优化和自生成数据增强实现能力跃升,并已在GPU内核优化等真实场景完成超千次工具调用、最长24小时的端到端验证。
Muse Code:面向终端开发者的编程智能体
Meta AI正式发布Muse Code(Beta版),一款运行于终端的AI编程智能体,专为处理大型代码库中的复杂软件工程任务设计。其核心能力涵盖任务规划、代码生成与结果验证全流程。不同于传统按需启动的单次任务型Agent,Muse Code采用一组持续存活的异步后台智能体,全程驻留于会话生命周期内,避免重复信息采集,自主决策执行节奏并主动向主智能体汇报进展,显著降低多步骤任务的延迟与引导开销。
运行机制:可回放、可恢复的本地事件日志
Muse Code采用本地只追加(append-only)事件日志作为统一状态源,完整记录每次模型调用、工具执行、人工审批及代码编辑操作。Meta将该设计称为“replay-exact”与“restart-safe”——系统崩溃后可精确恢复至中断点,保障长时间运行任务(如数小时级自动化重构或调试)的鲁棒性。该日志机制构成整个智能体运行时的基础信任层。
内置技能与部署方式
Muse Code默认集成三项核心技能指令:`/plan`将用户需求转化为需人工审批的分步执行计划;`/grill`对计划进行压力测试直至逻辑稳固;`/goal`驱动智能体持续推进直至目标达成。目前Beta版支持macOS与Linux系统,可通过curl命令一键安装:`curl -fsSL https://dev.meta.ai/install.sh | bash`。Muse Spark 1.2模型同步开放给Muse Code终端用户及Meta Model API调用者,全球范围内扩大访问权限。值得注意的是,官方未提供模型权重下载,当前仅以托管服务形式交付。
Muse Spark 1.2:深度协同训练的编码专用模型
Muse Spark 1.2是前代Muse Spark 1.1的编码能力强化版本,在代码生成质量、复杂缺陷调试、代码库理解深度及端到端开发工作流支持上均有提升。其训练关键创新在于三方面:一是与Muse Code执行框架联合训练,引入拒绝采样轨迹、目标条件化、上下文压缩及子智能体编排等优化策略;二是聚焦长周期任务建模,覆盖全仓库代码生成、大型端到端项目开发及自动技术调研;三是基于Muse Spark 1.1自生成高难度编码环境与评估模板,构建可扩展训练数据集,实现模型自我迭代。
实证评估与典型应用案例
Meta公布了详尽评测体系:Terminal-Bench 2.1(89项任务)、DeepSWE v1.1(91个仓库、5种语言共113项任务)及内部Coding Bench(440项源自真实Pull Request的任务)。所有测试均在隔离的Daytona云沙箱中执行,并与Grok 4.5、Claude Opus 5、GPT-5.6 Terra、Gemini 3.6 Flash及Kimi K3等主流模型的Agent产品横向对比。特别地,Meta强调其评测框架针对自身模型深度调优,第三方模型表现可能受限。在Terminal-Bench 2.1上,Muse Spark 1.1基准分为80.0,新版分数未公开但宣称显著提升。
一项重点案例展示其工业级潜力:Meta在NVIDIA Hopper GPU上开展GPU内核持续优化实验,累计执行超1000次工具调用,单次运行最长达24小时。模型自主完成内核编写、编译、性能剖析与迭代改进,针对KDA(以FLA Triton为基线)与MLA(以PyTorch batch=1为基线)两类典型内核实现结构化优化,验证了其在高性能计算基础设施领域的落地可行性。
编者观点
面向中国开发者工具厂商与AI原生IDE创业团队,Muse Code揭示了一条新路径:将强编码能力大模型与轻量级、可审计、可中断的终端Agent架构深度耦合,兼顾生产力与工程可控性——这或将成为下一代AI编程助手的关键差异化维度。
本文为企业智脑(优秘智能)编译整理自公开资讯,信息与观点以原文为准,仅供参考。阅读原文(MarkTechPost) →