阿里通义千问发布Qwen3.8-Flash-Next:125B稀疏激活多模态MoE模型
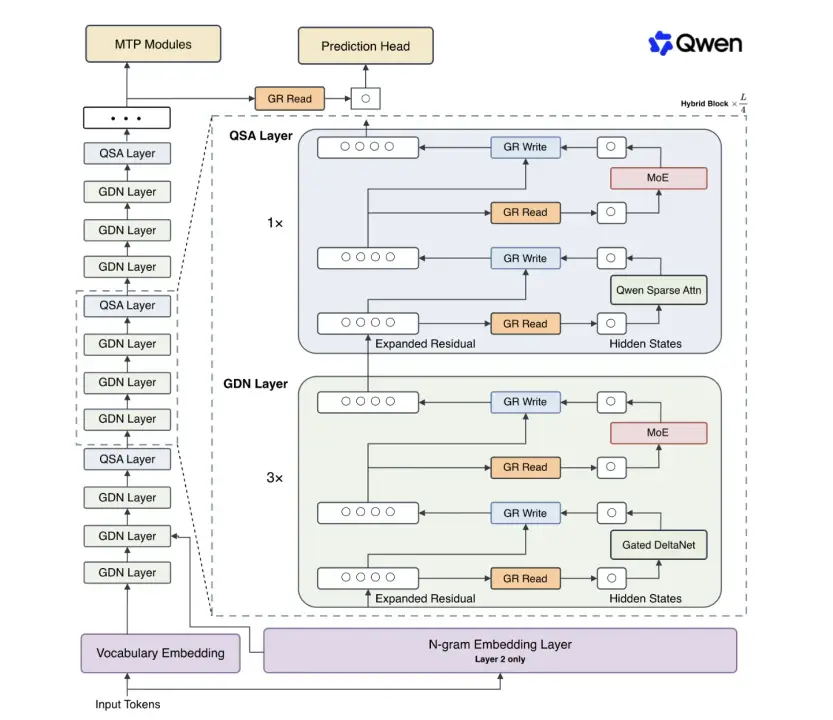
阿里通义千问团队正式开源Qwen3.8-Flash-Next,一款总参数量180B、单token仅激活6B参数的多模态混合专家模型,定位为下一代Qwen4架构的早期技术预览。该模型采用Gated DeltaNet与Qwen Sparse Attention混合注意力、门控残差、N-gram嵌入及Muon优化器四大创新,训练成本约为Qwen3.7-Plus的九分之一。
模型定位与核心架构
Qwen3.8-Flash-Next是阿里通义千问团队发布的开源多模态大模型,被明确界定为Qwen4架构的早期技术预览(early preview),类比此前Qwen3-Next对Qwen3.5的铺垫作用。模型整体设计聚焦于‘每Token成本优化’,采用稀疏激活的混合专家(MoE)路线。其磁盘存储总量达180B:包含一个125B参数的主干网络、一个51B参数的N-gram嵌入表,以及一个4B参数的多Token预测(MTP)模块;但实际推理中,每个Token仅动态激活约6B参数。
四大关键技术演进
模型升级由四项核心技术驱动:
- 混合注意力机制:全模型共48层,按“3×Gated DeltaNet(GDN)→1×Qwen Sparse Attention(QSA)”循环布局(即12组)。GDN是一种线性注意力变体,将历史上下文压缩为固定尺寸的循环状态;QSA则以微块(micro-block)粒度而非逐Token方式选取上下文,单次QSA调用预算为512微块(约2048 tokens)。
- 门控残差结构:残差流扩展为4条并行分支,每条分支配备元素级读门控与标量写门控,瓶颈维度设为320。
- N-gram嵌入表:在第2层引入含2000万词条的二元/三元语法嵌入表,通过确定性查表增强容量;支持异步预取至主机内存(当前仅限NVIDIA设备)。
- 训练优化器组合:采用Muon优化器与AdamW协同优化特定权重类别,取消batch size warmup,并重新拟合缩放律;MoE层含512个专家,每次路由激活10个专家加1个共享专家,专家中间维度为640。
性能与效率实测数据
在代码与智能体任务基准上,Qwen3.8-Flash-Next表现稳健:DeepSWE 1.1得分为58.7,SWE-bench Pro为62.5,SWE-bench Multilingual达81.0,LiveCodeBench v6为91.9;智能体评测中,CoWorkBench 73.9、JobBench 55.7、Toolathlon Verified 73.5;多模态任务如AndroidWorld(84.5)、LVBench(76.6)、RealWorldQA(88.5)及MathVision(95.7,启用代码解释器)亦取得高分。但在前沿推理任务(如HLE、NL2Repo-Bench)上仍落后于Claude Opus 4.6 Max与DeepSeek-V4-Flash-0731。
效率方面,官方称其训练成本约为Qwen3.7-Plus的1/9;服务端性能显示,QSA内核在100万tokens场景下可实现最高7.6倍prefill与4.9倍decode加速(vLLM与SGLang实测分别为10.2×和6.6×);在90%前缀缓存命中率下,prefill吞吐量达Qwen3.7-Plus的8.6倍。原生上下文长度为262,144 tokens,借助YaRN技术可扩展至1,000,000 tokens。
部署与使用方式
模型支持多种主流推理框架:vLLM、SGLang、TokenSpeed、transformers serve及llama.cpp(GGUF量化版);微调兼容Unsloth、Swift与LLaMA-Factory。目前已上线QwenWork平台‘标准模式’,并原生支持Qwen Code。默认启用‘思考模式’(thinking mode),提供xhigh/medium/low三级推理强度;推荐思考模式使用temperature=1.0、top_p=0.95,指令模式则建议temperature=0.7、top_p=0.80。FP8权重体积为172.78 GiB,BF16版本达335.28 GiB,需多GPU节点部署(vLLM验证最低配置为GB300平台TP2,推荐TP4;8×H200节点需用TEP8,普通TP8不兼容其128宽量化块)。
本文为企业智脑(优秘智能)编译整理自公开资讯,信息与观点以原文为准,仅供参考。阅读原文(MarkTechPost) →