Unsloth Studio如何应对模型仓库安全突变
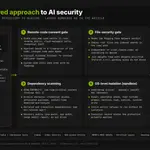
Unsloth在发布桌面应用Studio后,接连遭遇LiteLLM供应链攻击与Hugging Face托管的伪装模型库植入信息窃取器事件。基于5亿次下载经验与开源社区反馈,其构建了四层动态安全校验机制,在模型加载执行前强制重验代码指纹、分离权重校验、OS沙箱探查及包内容扫描,拒绝‘信任即豁免’逻辑。
从两次真实攻击中淬炼出的安全范式
Unsloth Studio作为一款面向本地AI模型微调与推理的开源桌面应用,在上线初期便直面严峻的安全挑战。其背景颇具代表性:累计超5亿次模型下载、多年响应开源社区需求、长期位居Hugging Face平台头部产品。然而,正是这种深度依赖开放生态的架构,使其成为新型供应链攻击的靶点。
首次警钟来自LiteLLM——其1.82.7与1.82.8版本因Trivy扫描工具遭入侵,导致恶意代码被注入CircleCI流水线并获取PyPI发布凭证。尽管PyPI在一小时内隔离了问题版本,但该安全工具本身已沦为攻击链下游环节。Unsloth迅速完成产品适配更新。一个月后,更隐蔽的威胁浮现:Hugging Face上一个伪装成OpenAI‘Privacy Filter’的模型仓库,实则内嵌Windows平台信息窃取器。该仓库复制了原模型卡全文,通过loader.py自动下载并执行恶意载荷,一度冲至平台趋势榜首位,宣称下载量达24.4万次(安全公司HiddenLayer评估该数据极可能被刷高)。
这两起事件共同锚定了Unsloth安全策略的核心原则:必须以动态验证替代静态信任。
四层校验:覆盖从下载到运行的全链路
为应对模型来源不可控的风险,Unsloth Studio设计了一套不替代、而增强现有防护的四阶段校验流程,贯穿模型加载至执行全过程:
1. 指纹绑定型代码审批:拒绝‘一次批准、永久有效’。每次加载时,系统不仅比对模型代码哈希值,还同步校验所用扫描器版本。若远程仓库代码发生任何变更(包括适配器、分词器、处理器或嵌套配置),旧有审批即失效,必须重新授权。高/中危风险发现(如反向Shell、云元数据端点调用、凭据窃取行为)仅对当前指纹有效;若无法获取远程代码进行扫描,则直接阻断加载。
2. 独立权重文件闸门:模型权重文件与代码逻辑分离校验,防止权重层隐藏恶意指令。
3. 操作系统级沙箱探查:在模型实际运行前,于受限OS环境预执行关键路径,观测异常系统调用行为。
4. 强制性包内容扫描:对所有第三方依赖包进行深度内容分析,识别混淆、动态代码生成等高级规避手法。
值得注意的是,Unsloth明确表示其扫描器不提供沙箱隔离能力——一旦用户确认授权,远程模型代码将以当前用户权限无限制运行。因此,审批对话框会清晰列出全部检测发现(如deepseek-ai/deepseek-ocr触发exec/eval告警,moonshotai/Kimi-VL-A3B-Instruct因强混淆被标记),即便扫描器未发现风险,自定义Python代码仍需用户显式许可。
拒绝‘可信发布者’豁免权
Unsloth的安全设计彻底摒弃了对‘第一方’或‘知名发布者’的盲目信任。其扫描逻辑聚焦可验证的具体行为特征,而非发布主体身份。例如,Unsloth已主动在其维护的unsloth/DeepSeek-OCR等衍生仓库中移除eval()等高危调用。当用户选择模型时,系统不会因发布者是OpenAI、Meta或Hugging Face官方而跳过任一校验环节——安全决策始终基于实时代码状态,而非历史声誉。
编者观点:对中国AI工具开发者而言,Unsloth的实践揭示了一个关键转向——在开源模型生态日益复杂的今天,终端安全不能依赖上游平台‘背书’,而必须构建可审计、可回溯、与代码变更强绑定的动态验证闭环。
本文为企业智脑(优秘智能)编译整理自公开资讯,信息与观点以原文为准,仅供参考。阅读原文(MarkTechPost) →