谷歌发布Gemini 3.8 Flash系列TTS语音模型
谷歌正式推出Gemini 3.8 Flash TTS与Flash-Lite TTS两款语音合成模型,分别面向创意语音设计与高吞吐量自动化语音生成场景。新模型支持超2000种预置声线、多语种区域变体及文本内嵌情感标记,并通过SynthID水印与C2PA元数据强化AI语音安全溯源。
双轨定位:面向不同语音生产需求
谷歌发布Gemini 3.8 Flash TTS与Gemini 3.8 Flash-Lite TTS两款语音合成(TTS)模型,首次将语音生成能力按使用场景进行功能拆分:Flash TTS聚焦交互式娱乐、游戏开发及长篇有声叙述,强调基于提示词的即时语音创意设计;Flash-Lite TTS则专为自动化媒体配音、面向客户的对话式AI代理及高并发翻译流水线优化,兼顾成本效率与部署规模。
超2000声线库与区域语言深度覆盖
新模型取代了原有30个固定语音样本的旧目录,提供包含2000余个预构建声线的可扩展目录,覆盖100多种语言及其地域变体,包括魁北克法语、苏格兰英语、墨西哥西班牙语等。即将推出的‘语音重混’模块允许音频工程师通过纯文本指令直接调节音色、音高、语速及口音轮廓,实现精细化声学控制。
独立评测验证性能领先性
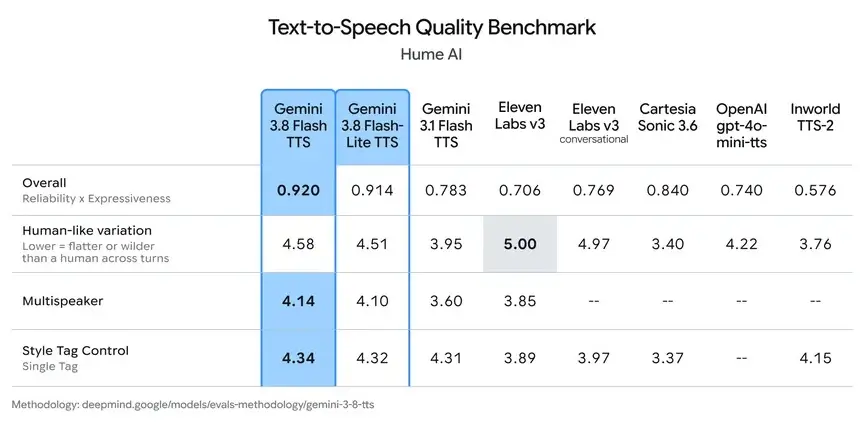
在Hume AI语音设计基准测试中,Gemini 3.8 Flash TTS综合得分为71.4,其中口音建模单项达60.8,位居同类模型首位;在Hume AI整体质量指数中,Flash TTS位列第一,Flash-Lite TTS排名第二,均显著优于前代Gemini 3.1 Flash TTS。Voice Arena平台开展的双盲人类听评显示,两款模型在日语、巴西葡萄牙语、越南语、现代标准阿拉伯语、墨西哥西班牙语及印地语等区域语言中获得更高偏好度。
长时长、多角色与自然交互增强
系统支持单脚本驱动双人对话,精准维持自然轮替节奏与声纹分离,适用于长时间连续对话场景。音频质量与角色音色稳定性经验证可在数小时级文件中保持一致,有效避免有声书录制与播客季更中的语音衰减问题。创作者可直接在文本中插入非语言声学标记(如`<laughs>`、`<sigh>`、`<gasp>`)及反应性口语短语(如`|mhm|`、`|yeah|`),动态调控对话节奏与表现力。
全链路安全机制:身份核验与内容溯源
语音克隆流程强制执行身份验证:复刻特定声线需同时提交30秒参考音频及由原声者亲述的明确口头授权录音;谷歌将对两段音频进行声学对齐校验后才启动定制建模。所有生成音频自动嵌入不可感知的SynthID音频水印及符合C2PA标准的加密溯源元数据,确保下游检测工具可准确识别合成语音资产。
多生态集成与企业级部署启动
开发者可通过Google AI Studio与标准Gemini API接入两款模型,并兼容Agora、LiveKit、Pipecat及Vercel等主流开发框架。早期商业集成已落地Figma、HeyGen、Linguana、Wondercraft、99.co与Ollama等平台,应用于区域媒体翻译与客户服务自动化。终端用户可在Gemini Notebook中直接调用Flash TTS,Google Vids则集成Flash-Lite TTS。面向Gemini Enterprise客户的企业级API管理权限将于后续部署波次中开放。
> 编者观点:该发布标志着TTS技术正从‘可用’迈向‘可编排、可治理、可规模化’阶段——中国企业若布局AIGC语音产品,需同步构建声线多样性供给体系、文本-语音协同提示工程能力,以及符合国内监管要求的合成内容标识与溯源机制。
本文为企业智脑(优秘智能)编译整理自公开资讯,信息与观点以原文为准,仅供参考。阅读原文(AI News) →