谷歌发布TimesFM-3:3.3亿参数零样本多变量时序预测基础模型
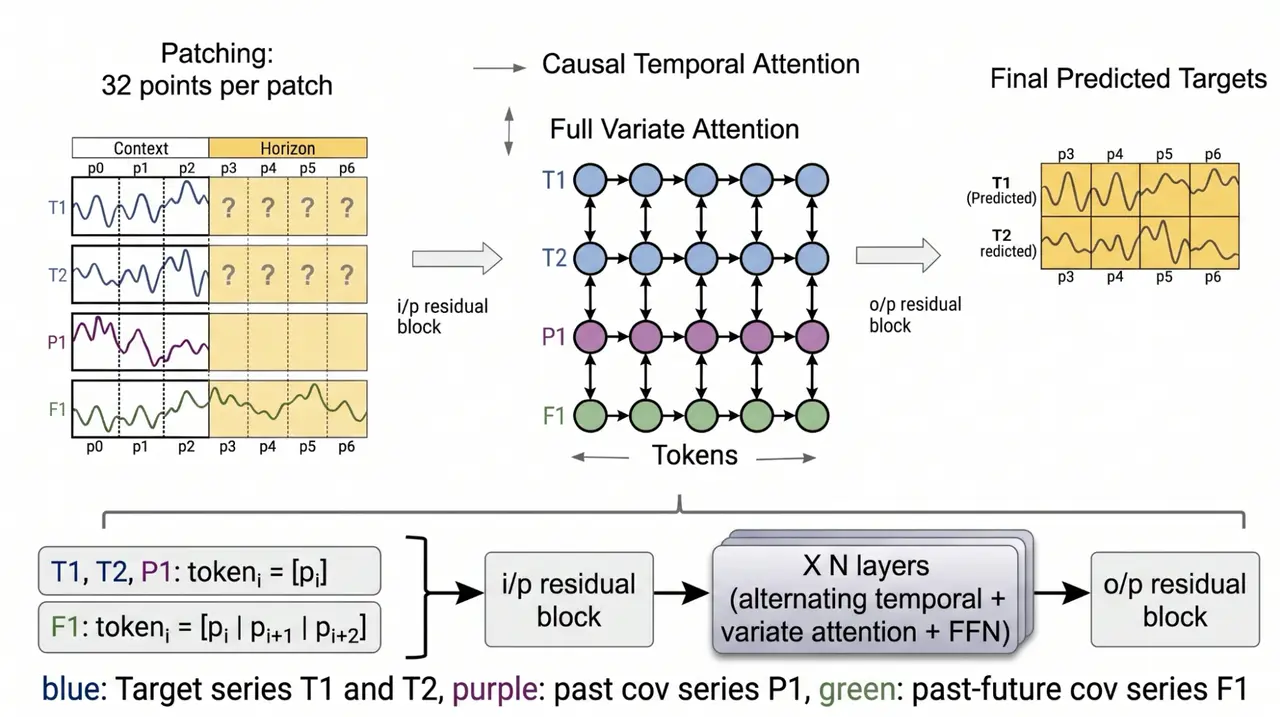
谷歌AI正式发布TimesFM-3,一款原生支持多变量时序预测的3.3亿参数基础模型,可在单次前向传播中联合预测多个目标序列,并支持历史协变量与已知未来协变量。该模型在GIFT-Eval、fev-bench和TIME三大权威基准上均位列预训练基础模型榜首,但权重仅限非商业、非生产用途。
原生多变量架构突破
TimesFM-3是谷歌Research推出的第三代时序基础模型,参数量为3.3亿,核心突破在于首次实现对多变量时序预测的原生(natively)支持。此前所有TimesFM版本(至2.5)均为单变量设计——仅基于单一序列自身历史进行预测。而现实场景(如冰激凌销量预测)往往涉及销售数据、客流量、天气、促销日历、节假日等多源关联信号。TimesFM-3直接在超大规模数据上预训练:覆盖超1万亿真实与合成时间点,输入支持三类零样本(zero-shot)信号——多个目标序列联合预测、仅历史已知的协变量(如过往客流量)、以及未来值已知的协变量(如预先排期的促销活动日历),全程无需任务特定微调。
双重注意力机制与分块建模
模型主干沿用解码器-only Transformer架构。其关键创新在于输入表征与注意力设计:连续时间点被划分为每块32步的‘时间片’(patches),并按序列独立归一化,以消除量纲差异干扰;目标与历史协变量token来自同一时间片,而未来协变量则采用‘前瞻拼接’技巧——将当前块与后续若干块拼接,使模型在时间步发生前即感知已知未来事件。Token随后映射为2D网格,经由两类交替注意力层处理:因果时间注意力(水平方向)严格遵循时序因果性,仅允许访问同序列内更早token;全变量注意力(垂直方向)则在每个时间步让某序列token读取所有其他序列在同一时刻的值,从而无监督地学习跨序列相关性。
单次前向生成完整预测区间
为提升效率与鲁棒性,TimesFM-3摒弃早期逐块自回归解码方式,转而采用‘连续时间片掩码’(Contiguous Patch Masking)策略——在训练时,为整个预测区间统一添加掩码占位符;目标值与历史协变量在此区间被掩码,而已知的未来协变量保持可见。通过交替注意力层协同作用,模型在单次前向传播中即可同步填充全部掩码位置,输出每个时间步的9个分位数(10%至90%),兼顾点预测与概率预测能力。
权威基准全面领先,但商用受限
谷歌在GIFT-Eval、fev-bench及TIME三大公开时序评测基准上对比Chronos-2、Toto 2.0系列及TimesFM-2.5。结果显示:TimesFM-3在全部三个榜单的点预测与概率预测指标平均排名中,均位居所有预训练基础模型首位。具体而言,其在fev-bench的100个真实世界任务中综合排名第一;在TIME涵盖50个领域数据集、98项评估任务中整体排名第一;在GIFT-Eval中亦为预训练模型类别第一。然而,TimesFM-3模型权重采用‘timesfm-non-commercial-license-v1.0’授权,明确限制仅可用于非商业、非生产环境;若需商用部署,TimesFM-2.5(Apache-2.0许可)仍是当前唯一合规选项。
本文为企业智脑(优秘智能)编译整理自公开资讯,信息与观点以原文为准,仅供参考。阅读原文(MarkTechPost) →