H公司发布NeoMME:双规模单塔多模态编码器
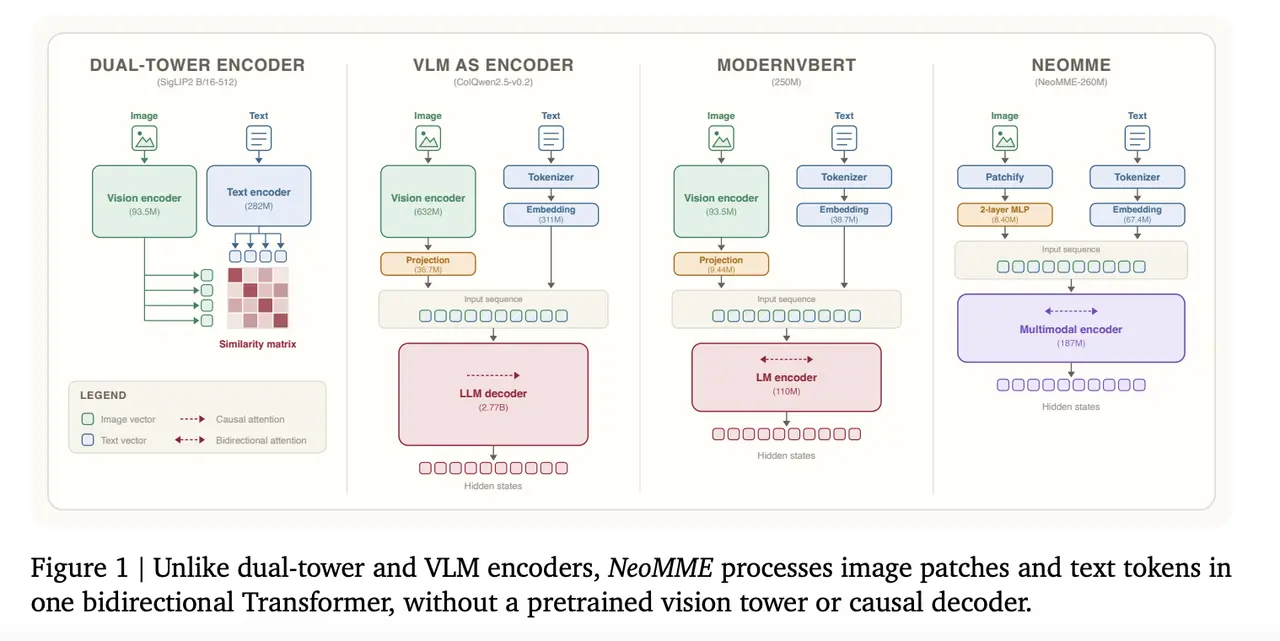
H公司推出NeoMME系列多模态编码器,含260M与800M两种参数量,摒弃传统视觉塔与因果解码器,采用统一Transformer处理文本与图像块。其检索微调版NeoMME-Retriever在ViDoRe v3上达0.523 nDCG@10,支持Apache 2.0开源,已在Hugging Face Transformers中开箱即用。
革命性架构:单塔统一处理双模态
当前生产环境中主流的视觉文档检索模型(如ColPali及其衍生模型)多为生成式多模态大模型的‘二手改造’——保留独立预训练的视觉塔和从不生成token的因果解码器,造成参数与算力冗余。H公司发布的NeoMME彻底重构范式:它是一组纯双向编码器(260M与800M参数),完全移除视觉塔与因果解码器。文本与图像通过同一Transformer主干联合处理:文本经ALBERT式因子化嵌入(256维查表后投影至模型宽度),图像则被划分为非重叠的32×32 RGB图像块,并由从零训练的两层MLP完成投影。无Patch-Merging模块,亦无SigLIP2视觉塔。两种模型均支持16,384 token上下文长度,足以容纳两张标准4K UHD(3840×2160)图像分块后的全部输入。
高效训练与创新预训练机制
模型堆栈采用多项先进设计:对称滑动窗口注意力(每第六层及最终层启用全局注意力)、分组查询注意力(GQA)、查询-键归一化、门控注意力、2D旋转位置编码及平方ReLU激活的MLP。精确参数量分别为262,937,906与793,715,032。词元器为从零训练的无空格约束BPE,词汇表大小131,072,在FLORES-200的14种语言测试集上,其输出token数比ModernBERT少44.4%。预训练采用离散掩码扩散去噪范式:文本段落随机选取0–1的掩码率;多模态段落则限定于0.30–1,以消除纯文本捷径、强制模型理解页面内容。跨模态消融实验证实该策略有效——在90%高掩码率下,可见图像块使掩码token预测准确率分别提升38.4分(260M)与40.5分(800M)。训练数据总量约5240亿打包输入token(其中文本token约2900亿),分别在16块与32块H100加速器上完成。
检索性能与轻量化部署能力
NeoMME-Retriever在共享主干上联合训练两个头部:一是带Matryoshka宽度的均值池化稠密头;二是晚期交互头,将每个文本token与图像块均投影至128维。单次前向传播即可输出两者。在ViDoRe v3基准上,260M模型达0.523 nDCG@10,与参数量高达3.75B的ColQwen2.5-v0.2仅差0.002,且领先其他所有<300M参数模型26.1分;800M模型得分为0.556,略低于同规模Vultron Retriever Flash(低0.9分)。在ViDoRe v1/v2上,两模型nDCG@5分别达0.860/0.522与0.874/0.559。文本检索能力相对较弱:在BEIR-15上,晚期交互头得分分别为0.4881与0.5126,而149M参数的LateOn达0.5722,作者归因于监督信号规模差异——NeoMME仅使用约43万文本查询样本,而mLateOn使用约6.6亿对比学习样本。
存储优化与实时推理效率
晚期交互索引存储开销较大:单张2048×2048页面生成4162个向量,float32格式下每份ViDoRe v3文档约需1.5 MB。团队提出两种压缩方案:1)层级token池化(压缩因子10)+ int8量化查询与文档,单页降至39.0 kB(压缩39.4倍),nDCG@10保持率达99.16%;2)压缩因子8 + int8查询 + 二值化文档,单页仅6.0 kB(压缩255.5倍),nDCG@10保持率95.19%。推理吞吐表现优异:在单块NVIDIA L40S上,NeoMME-260M对2048×2048输入的编码速率达51.3页/秒,是ColModernVBERT(26.0页/秒)的1.97倍;CPU-only主机上单次查询编码耗时仅78.3毫秒。所有检查点均以Apache 2.0协议开源,已原生支持Hugging Face Transformers。
本文为企业智脑(优秘智能)编译整理自公开资讯,信息与观点以原文为准,仅供参考。阅读原文(MarkTechPost) →