NVIDIA用Palantir Foundry与cuOpt优化全球硬件供应链分配
NVIDIA正依托Palantir Foundry构建数字供应链指挥中心,并集成其开源GPU加速优化库cuOpt,以自动化协调全球制造基地的硬件组件分配。该系统将‘所有权时间’(TOO)作为核心优化目标,并引入经领域微调的Nemotron 3.5 Lightning大模型,融合非结构化运营数据提升决策准确率。
数字指挥中心:Foundry构建统一运营图谱
NVIDIA已部署Palantir Foundry作为其‘数字供应链智能’指挥中心的核心平台。Foundry的本体(Ontology)模型将全球工厂、供应商承诺、组件库存及生产目标建模为相互关联的对象与关系链,形成覆盖全链条的动态运营知识图谱。这一结构化层为后续决策引擎提供了统一、实时的数据底座。
cuOpt驱动混合整数线性规划优化
在Foundry构建的数据层之上,NVIDIA调用自研开源库cuOpt——一款专为GPU加速设计的决策优化工具。cuOpt将供应链分配问题形式化为以最小化‘所有权时间’(Time of Ownership, TOO)为目标的混合整数线性规划(MILP)问题。TOO定义为从工厂接收物料到完成子装配体交付的全过程耗时。cuOpt不仅输出周度交付计划,还能识别瓶颈环节,例如特定区域的组装产能上限与HBM3e内存实际可供应量之间的不匹配。
Nemotron 3.5 Lightning补足非结构化变量盲区
纯数学优化难以捕捉人类计划员依赖的非结构化信号,如供应商电话纪要、区域天气预报、合作伙伴邮件往来及地缘政治事件。为此,NVIDIA对开源MoE大模型Nemotron 3.5 Lightning(总参数300亿,单次前向激活约30亿)开展领域后训练。工程流程包括:使用NeMo Anonymizer脱敏敏感字段;通过NeMo Data Designer平衡真实历史样本与合成产能中断场景;采用NeMo AutoModel实施LoRA微调,冻结基座权重。Palantir Autopilot负责端到端的数据溯源、模型版本追踪与推荐结果分发。
实测性能与持续演进路径
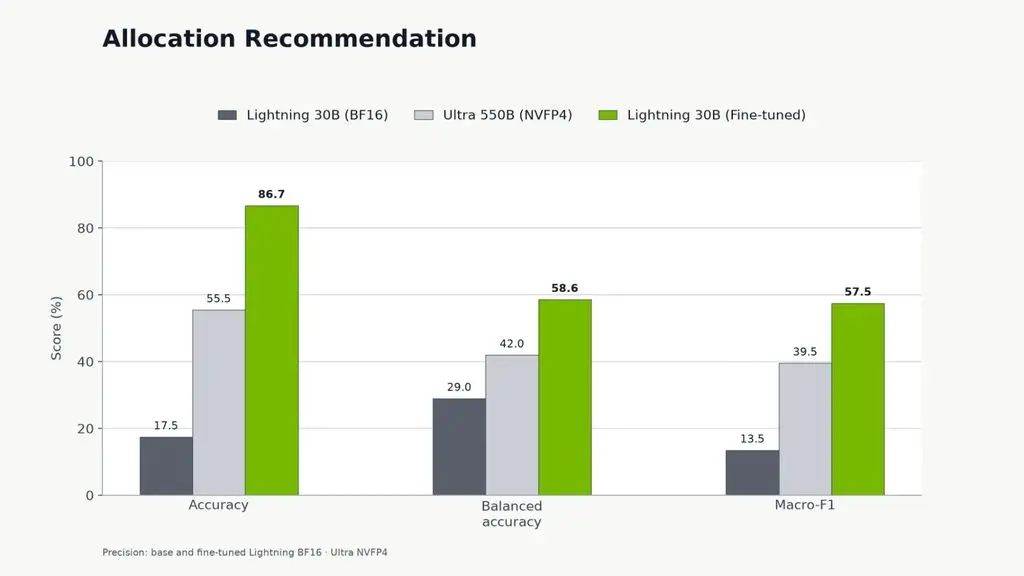
在历史分配记录测试中,后训练版Nemotron 3.5 Lightning决策准确率达86.7%,显著高于未调优的Lightning基座模型(17.5%)和更大参数量的Nemotron 3 Ultra(55.5%);其平衡准确率(58.6%)与宏F1分数(57.5%)亦全面超越Nemotron 3 Ultra(42% / 39.5%)。全部微调仅需两块NVIDIA B200 GPU,耗时数分钟。当前模型已提升日常分配质量,但对更长期运营风险的预测能力仍有限。所有实际操作记录——包括人工修订、策略覆盖与产线实绩——均实时回写至Foundry本体。NVIDIA确认,这些带反馈的闭环数据将用于构建强化学习所需的偏好对(preference pairs),评估标准涵盖分配精度、政策合规性与证据支撑强度;而生产模型严格隔离于任何未经监控的再训练流程之外。
本文为企业智脑(优秘智能)编译整理自公开资讯,信息与观点以原文为准,仅供参考。阅读原文(AI News) →