Token Saver开源工具:本地混合RAG将Claude处理PDF的Token成本降低90–99%
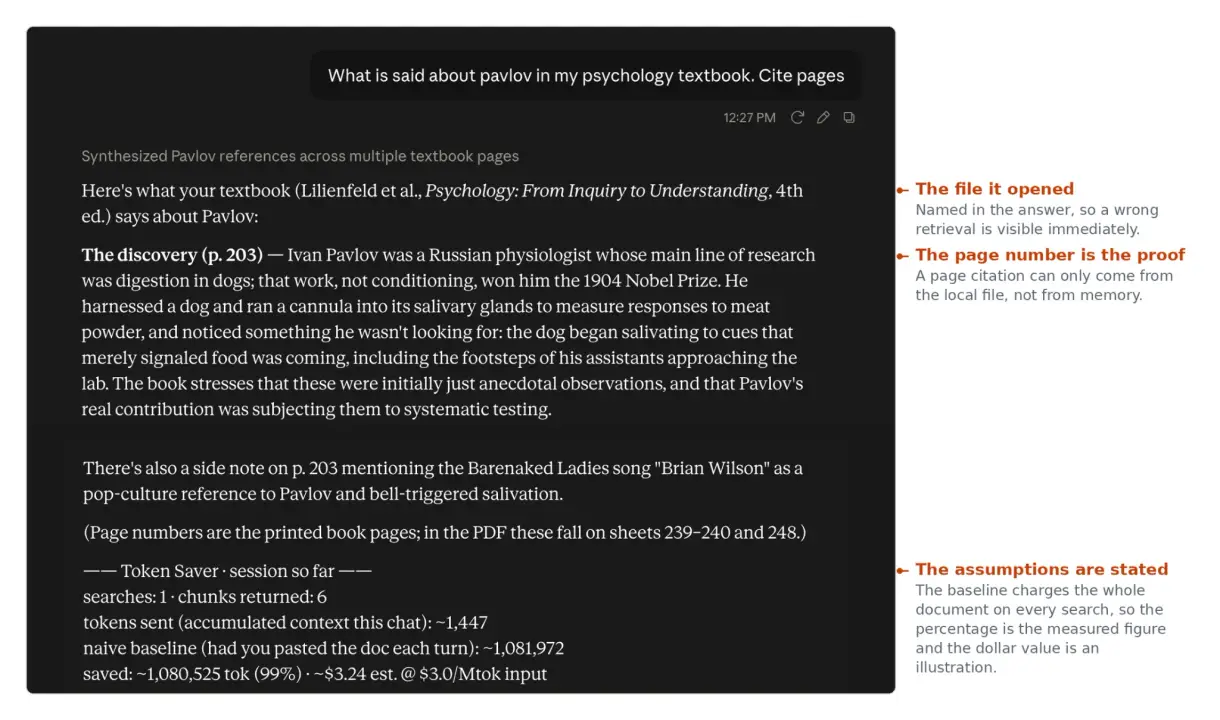
Marktechpost AI团队发布开源MCP扩展Token Saver(MIT许可,v1.0),专为Claude Desktop设计。该工具通过本地运行的混合RAG(BM25+本地MiniLM嵌入)实现PDF内容检索,PDF全程不上传、不离本地硬盘,实测在233页法律文书等场景下Token消耗减少99.4%。
为何PDF分析成倍推高Token成本?
用户常误以为将PDF拖入Claude仅触发一次文本提取。实际上,Claude默认将每页转为图像以保留图表与排版,同时单独提取文本——仅文本部分就达每页1500–3000 tokens。更关键的是,每次追问均需重传全部上下文,导致整份文档反复计费。即便启用Prompt Caching或Claude Projects,文档仍须完整上传至服务商服务器。对仅需两段内容的千页教材而言,让LLM全量扫描不仅低效,还易引发幻觉。
本地混合RAG如何破局?
Token Saver作为轻量级本地MCP服务器运行,Claude将其调用为内置工具。PDF全程保留在用户硬盘,不上传、不联网。当用户提问时,系统启动本地混合RAG检索:结合BM25关键词匹配(SQLite FTS5,权重0.4)与语义搜索(本地all-MiniLM-L6-v2嵌入模型,余弦相似度,权重0.6)。二者协同筛选出高相关片段,仅将精准答案段落(含精确页码)提交Claude生成回复,并实时显示已节省Token数。
八步本地处理流水线
Token Saver在单进程内完成全部处理,严格前置于Claude推理: 1. Extract:用pypdfium2(pypdf备用)提取文本; 2. Chunk:按180词切分,重叠40词保障语境连贯; 3. Score:混合BM25与本地嵌入模型打分; 4. Gate:设质量阈值——无共现关键词者,语义相似度须≥0.25; 5. Deduplicate:剔除近似重复段落; 6. Trim:精炼至仅含直接回答问题的句子; 7. Budget:向Claude发送内容严格限制在8000字符内; 8. Envelope:封装为带源文件名与精确页码的document-chunk元素。 (注:嵌入模型为可选组件;加载失败时自动降级为纯关键词检索。)
实测效果:文档越大,节省越显著
因返回文本量被硬性截断,Token节约随文档规模呈指数增长。基准测试(tiktoken/cl100k_base计数,单次提问/文档)显示:
- FDA药品标签(33页):全文23,959 tokens → 返回1,021 tokens,节省95.7%;
- GDPR法规(88页):70,260 → 996,节省98.6%;
- SFFA诉哈佛案判决书(233页):133,349 → 740,节省99.4%。
该工具显著消除法律意见、技术标准、财报及专业教材等高频文档场景下的重复Token税。
隐私与安全三重保障
面向企业与法律从业者,Token Saver构建零信任隐私模型:
- 零上传:文档永不离开本地设备;
- 目录白名单:用户预设唯一授权文件夹,服务器拒绝访问该路径外任何文件;
- 网络隔离:默认禁用外网连接,所有处理纯离线执行。
本文为企业智脑(优秘智能)编译整理自公开资讯,信息与观点以原文为准,仅供参考。阅读原文(MarkTechPost) →