webAI发布TwIL-LM:1.7B与3B参数 formal-logic 模型家族
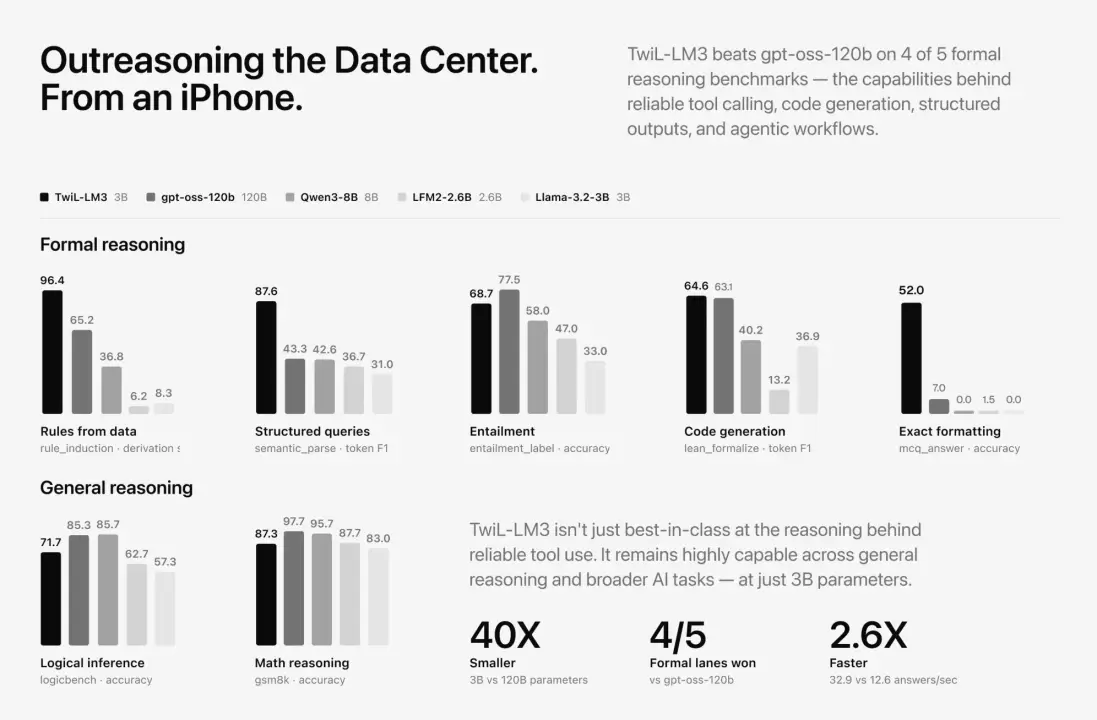
webAI正式发布TwIL-LM模型家族,包含1.7B和3B两个参数规模的专用形式逻辑模型,专为本地设备上的自动形式化(autoformalization)任务设计。模型支持英语到一阶逻辑翻译、前提蕴含判断等任务,均以非商用许可发布,可运行于CPU或仅4GB显存环境。
专注形式逻辑的轻量级本地模型
webAI近日发布TwIL-LM模型家族,包含两个参数规模的专用模型:1.7B参数的TwIL-LM和3B参数的TwIL-LM3。二者均面向“自动形式化”(autoformalization)核心任务,即把自然语言(英文)精准转化为形式化的一阶逻辑表达式,并验证结论是否严格从前提中逻辑蕴含。所有模型均针对本地部署优化,无需依赖云端API——1.7B版本提供1.06 GB量化GGUF格式,3B版本为1.78 GiB Q4_K_M GGUF格式,可在仅4 GB VRAM的GPU或纯CPU环境下运行。
许可与商用限制明确
TwIL-LM系列当前仅开放非商用使用,两个检查点均采用《webAI非商用许可证v1.0》。任何产生收入的部署场景(无论企业规模大小)均需另行与webAI签署商业授权协议。
应用场景聚焦高合规性领域
webAI强调其本地执行能力适用于数据不可离境的敏感环境,目标行业包括:合规与监管科技(RegTech)、金融服务、医疗与制药、法律及合同运营、以及形式化方法研究。具体应用涵盖:一阶逻辑(FOL)翻译、前提集蕴含分类、自然语言转结构化查询、Lean定理证明辅助起草与审校,以及作为“验证层”对更大模型输出进行逻辑正确性核查。
模型构建采用四阶段精调流程
TwIL-LM3基于SmolLM3-3B基座模型构建,共经历四个关键阶段:(1)在合成形式逻辑语料上进行LoRA监督微调;(2)参数空间内融合多个中间SFT检查点;(3)采用WiSE-FT插值技术,以λ=0.25权重向原始预训练基座回拉(即仅保留25%微调增量);(4)引入MGPO(熵加权GRPO)阶段,由程序化验证器驱动优化。最终发布的检查点为第2071步。值得注意的是,未采用WiSE-FT插值的对照分支虽在领域内指标更高(宏观门限0.515),但泛化能力显著下降(保持集能力损失约12分),因此未被公开。
性能表现:效率优势突出,综合能力稳居中型模型前列
在六项形式推理基准测试中,TwIL-LM3在规则归纳(96.4)、语义解析(87.6)、Lean形式化(64.6)、精确格式回答(52.0)和蕴含标注(68.7)上取得全面结果。其领域内六任务平均分为0.4488,宏观门限得分为0.4218,超越参数量相近甚至更大的多个竞品(如LFM2.5-8B-A1B),但落后于Qwen3-8B(0.5336)和gpt-oss-120b(0.5192)。然而在效率维度,TwIL-LM3优势显著:生成长度最短(482 tokens),达32.9答案/秒,远超120B模型的4.2答案/秒。泛化性方面,其在保持集核心平均分提升+0.022,LogicBench提升至0.7167;通用能力GSM8K小幅下降至0.8733,IFEval则回落至0.6433。1.7B版本宏观门限得分为0.361(基座模型为0.185),但在部分跨分布任务(如ARC-C CoT)上出现明显下降。
编者观点
TwIL-LM系列凸显了垂直领域小模型通过架构适配与训练工艺创新,在特定高价值任务(如合规逻辑验证)中实现‘够用、可控、可嵌入’的技术路径,为中国企业探索AI在金融、法律、医疗等强监管场景的轻量化落地提供了新参考。
本文为企业智脑(优秘智能)编译整理自公开资讯,信息与观点以原文为准,仅供参考。阅读原文(MarkTechPost) →