智谱GLM-5.3网络安全能力三重评估:发现领先、利用落后
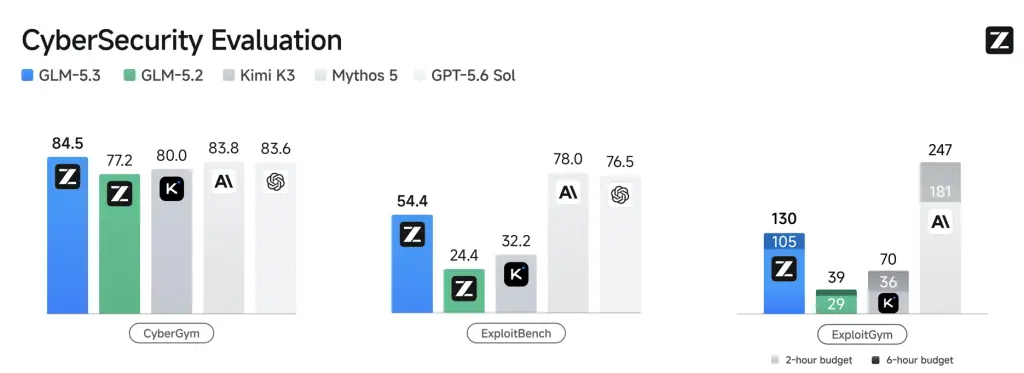
智谱AI发布GLM-5.3模型,其在漏洞发现基准CyberGym上以84.5%得分小幅领先Anthropic Mythos 5(83.8%)和OpenAI GPT-5.6 Sol(83.6%),引发外媒关注。但完整测评显示,该模型在更难的漏洞利用任务ExploitBench与ExploitGym上显著落后于竞品。智谱在技术说明中坦承:‘能力增长最快之处,恰是我们最落后的领域’。
漏洞发现领先,但利用能力明显滞后
智谱AI(Z.ai)于8月14日发布编码优化大模型GLM-5.3,并在其技术发布说明中披露了三项网络安全基准测试结果。其中,CyberGym测试聚焦‘漏洞发现’——即模型能否从源代码中识别可利用缺陷并验证其真实性。GLM-5.3在此项取得84.5%准确率,略高于Anthropic Mythos 5的83.8%和OpenAI GPT-5.6 Sol的83.6%。这一微弱优势(0.7个百分点)成为多数报道的核心 headline。
然而,另两项更贴近真实攻防场景的测试却呈现截然不同图景。ExploitBench要求模型不仅识别漏洞,还需推理其实际利用路径;GLM-5.3得分为54.4%,不足Mythos 5(78.0%)和GPT-5.6 Sol(76.5%)的七成。ExploitGym则衡量单位时间内完成的完整利用任务数:在2小时时限内,GLM-5.3完成105项,而Mythos 5完成181项;6小时时限下,前者为130项,后者达247项。智谱在说明中明确指出:‘测试越靠近漏洞利用链条下游,我方模型相对差距越大’。
测试方法与比较对象存在多重模糊性
报道混淆部分源于智谱在不同章节使用了Anthropic的不同模型作为参照:主基准表对比的是Claude Opus 4.8;性能图表采用Fable 5;网络安全专项则切换至Mythos 5。三者并非同一模型迭代版本,亦无公开可比性声明。在编码能力方面,GLM-5.3对Opus 4.8呈部分领先、部分落后态势;智谱亦坦承,其模型在内部编码基准上仍落后于Claude Fable 5。
更值得注意的是测试执行环境:所有网络安全评测(含CyberGym、ExploitGym等)均在Anthropic开发的Claude Code 2.1.207代理环境中运行。这意味着,一个中国开源权重模型的前沿能力评估,实际依赖于美国公司构建的工具链基础设施。
单次运行结果与未公开参数削弱结论稳健性
CyberGym的84.5%得分基于单次运行(pass@1),覆盖1507个任务,原文未提供标准差或多次运行结果,0.7个百分点的领先缺乏统计显著性支撑。此外,ExploitGym的时间归一化处理引用了Artificial Analysis的吞吐率数据,并列出了GLM-5.3、Kimi K3及Qwen3.8 Max的重标度系数,但Mythos 5的对应系数却未予披露,影响横向可比性。
真实代码库验证:269个项目发现2436个漏洞
除基准测试外,智谱联合中国多家安全团队,在269个开源项目真实代码库中部署GLM-5.3进行扫描,共识别出2436个漏洞,按CVSS严重程度划分:107个‘严重’(Critical)、990个‘高危’(High)、1286个‘中危’(Medium)、53个‘低危’(Low)。最古老漏洞可追溯至2004年,印证模型对历史遗留风险具备一定感知能力。需注意,该结果未说明人工复核比例、误报率及修复验证情况。
编者观点: benchmark领先不等于实战优势,工具链依赖暴露生态短板
单一漏洞发现指标的短暂领先易被放大为技术代差,但智谱主动披露的‘发现—利用’能力断层,恰恰反映当前国产大模型在安全推理纵深上的真实瓶颈;更值得警惕的是,评测高度依赖海外Agent工具链,凸显我国在AI原生开发与安全协同基础设施层面的系统性追赶空间。
本文为企业智脑(优秘智能)编译整理自公开资讯,信息与观点以原文为准,仅供参考。阅读原文(AI News) →