企业智脑优秘智能
产品▾
功能总览
它到底能替你干什么
十大军师
AI 决策顾问,出主意还给成品
岗位技能库
30 个精选技能,把高频工作接走
公司智脑 · 知识库
问一句就答、带出处,可私有化
老板驾驶舱
经营一屏统览,AI 辅助决策
产品规划 · 路线图
在做什么、接下来做什么
解决方案▾
🧭 AI 化成熟度自测
3 分钟测出你的 AI 化阶段 + 建议
全部行业方案
100+ 细分行业,一行业一方案
🏭 电子制造
🛍️ 服装零售
🎓 K12 辅导
🏥 医美机构
🍽️ 连锁餐饮
共建计划▾
共创共建 · 需求墙
你提需求、给功能投票,票高的先做
灯火计划
点点灯火,聚成灯塔 · AI 开源共建
行业资讯
关于▾
关于我们
客户案例
定价方案
常见问题
联系我们
登录 / 注册
行业资讯 · 每小时更新

企业 AI 化怎么落地,每天看一眼

我们把全球 AI 前沿资讯编译成给中国企业主看的中文洞察——每条都标注来源、可查原文。看别人怎么用,想清楚自己怎么做。
全部大模型算力·芯片AI智能体AI应用具身智能安全·治理行业动态
算力·芯片

深度求索拟建全球最大昇腾芯片推理集群

深度求索计划在内蒙古数据中心部署16万台华为昇腾950DT芯片,专用于AI推理任务,将成为目前已知规模最大的华为芯片集群。但受限于产能瓶颈,华为预计交付周期将超过一年。
来源 The Decoder · 2026-09-04
算力·芯片

英伟达发布RTX Spark‘超级芯片’,首批AI PC亮相

在IFA 2026展会上,英伟达联合合作伙伴首次展示搭载RTX Spark芯片的笔记本电脑与迷你PC。该芯片专为本地运行AI模型设计,标志着真正意义上的AI PC正式落地。

来源 WIRED · 2026-09-03
⚙️算力·芯片The Decoder · AI 洞察
算力·芯片

奥特曼警告AI算力建设存在“不可持续的荒谬”

OpenAI CEO山姆·奥特曼批评全球AI数据中心建设过热,指出大量新兴云服务商宣布超大规模算力容量却缺乏实际客户支撑。他坦言,算力成本持续下降可能使当前数十亿美元级项目迅速沦为不良投资,这一风险同样适用于OpenAI自身。
来源 The Decoder · 2026-09-03
算力·芯片

Perplexity开源Lily:专为Apple Silicon优化的Qwen3.6-35B-A3B推理引擎

Perplexity公司开源Lily——一款纯Rust与Metal实现的本地推理引擎,专为在Apple Silicon设备上高效运行Qwen3.6-35B-A3B模型而设计。它绕过PyTorch和MLX,通过深度硬件与模型结构协同优化,在prefill和decode阶段分别实现1.23倍与1.35倍于MLX-LM的吞吐量。4-bit量化模型体积为19.4 GB,需配备32 GB及以上统一内存的Mac设备。
来源 MarkTechPost · 2026-09-03
算力·芯片

长江存储量产首代HBM3E芯片

中国头部存储厂商长江存储(CXMT)已小批量生产HBM3E高带宽内存芯片,该芯片广泛应用于当前主流AI处理器。此举标志着中国在高端AI内存领域取得实质性突破,有望缓解对海外HBM供应的依赖。

来源 The Decoder · 2026-08-31
算力·芯片

Anthropic与Nscale达成450亿美元算力协议

据彭博社报道,人工智能公司Anthropic已与英国云初创企业Nscale签署一项价值约450亿美元的算力供应协议。该交易在Anthropic筹备首次公开募股(IPO)前夕达成,旨在保障其未来大模型训练与推理所需的高性能计算资源。

来源 The Decoder · 2026-08-27
算力·芯片

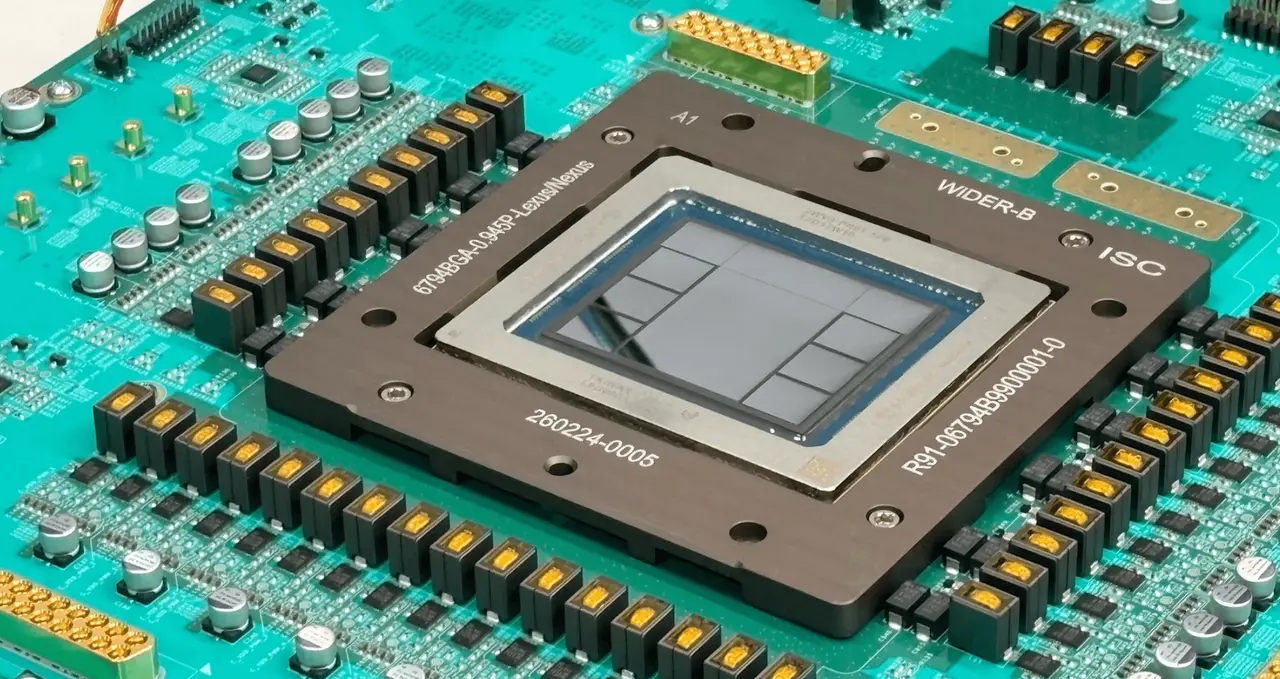
OpenAI首颗自研芯片“Jalapeño”推理性能超英伟达Blackwell与Rubin

OpenAI在Hot Chips大会上首次展示其首款自研推理芯片“Jalapeño”。SemiAnalysis实测显示,该芯片在吞吐量和能效两方面均优于英伟达Blackwell架构芯片,甚至超越尚未发布的Rubin架构。分析机构指出,这在业界罕见——通常首代自研芯片难以对标头部厂商旗舰产品。

来源 The Decoder · 2026-08-26
算力·芯片

Meta发布MetaRoCE:专为AI规模以太网设计的全新RDMA传输协议

Meta推出全新RDMA传输协议MetaRoCE,摒弃传统RoCE对无损网络的依赖,转而将排序、路径选择与丢包恢复能力下沉至智能网卡(NIC),适配大规模AI训练场景。该协议已开源规范与参考实现,预计2026年10月随OCP全球峰会正式交付,硬件支持尚处早期阶段。

来源 MarkTechPost · 2026-08-26
算力·芯片

英伟达称Groq 3 LPX推理芯片速度超Cerebras四倍

英伟达宣布其Groq 3 LPX推理芯片已进入全量生产,并在Gemma-4 31B模型上实现3400 tokens/秒的推理速度,宣称是Cerebras方案的四倍。但对比前提是英伟达需部署至少64颗加速器,而Cerebras仅需1–2颗。该性能差异背后的实际能效与扩展性仍存疑问。

来源 The Decoder · 2026-08-25
算力·芯片

OpenAI推出定制推理芯片Jalapeño

OpenAI宣布其自研AI推理芯片Jalapeño首测结果:在现代大模型推理中实现行业领先的处理速度与能效。该芯片显著提升吞吐量,降低延迟。

来源 OpenAI · 2026-08-25
算力·芯片

Cerebras发布CS-4 AI加速器,同芯片性能翻倍

Cerebras公司正式推出新一代AI加速器CS-4,据CEO Andrew Feldman称,其为当前行业最快系统。该设备在未更换芯片的前提下实现性能提升一倍。

来源 The Decoder · 2026-08-24
算力·芯片

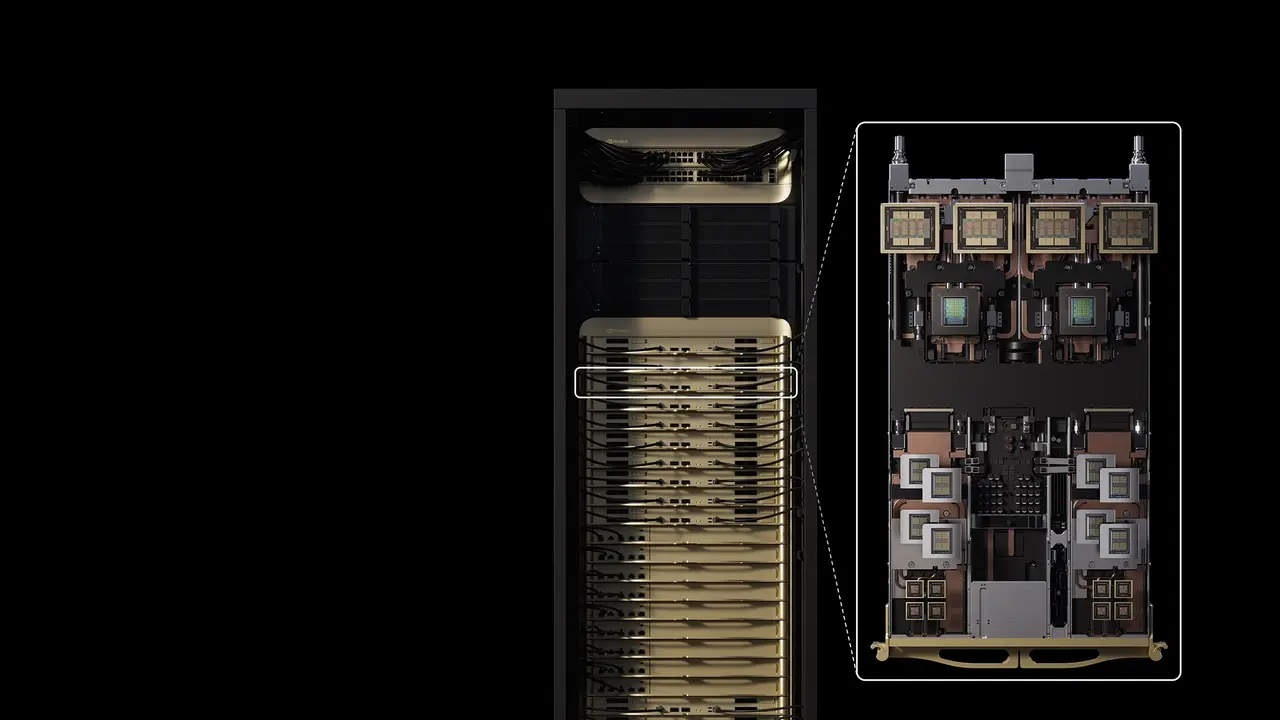
DRAM短缺致英伟达AI服务器涨价约15%

据彭博社报道,受三星、SK海力士和美光三大厂商DRAM供应持续紧张影响,搭载Vera Rubin与Grace Blackwell芯片的英伟达AI服务器价格将上涨约15%。微软、谷歌、Meta等云巨头正大规模投资AI基础设施,却因此进一步强化了其试图摆脱依赖的内存供应商的市场地位。

来源 The Decoder · 2026-08-23
共 38 篇 · 第 2/4 页
← 上一页
1234
下一页 →
现在开始

看完别人怎么做,轮到你了

预约一次免费 AI 化诊断,15 分钟帮你理清最该先做的场景。

✓ 2000+ 企业信赖🔒 信息严格保密⚡ 15 分钟理清 AI 化路径

⚡ 已服务 2000+ 企业,含南方电网、蒙牛、五菱等,平均获得 3 条可落地建议

企业智脑还在开发中,早期用户免费使用——不只是用,更能一起共建:提需求 / 投票·加入灯火计划
开发中·一起共建早期用户免费使用,加入共创共建,第一时间体验新能力
📞 18148527656
企业智脑

让 AI 成为每家企业用得起、用得好的经营基础设施。

深圳市龙岗区坂田街道天安云谷二期 4 栋 3203
电话 18148527656 · 微信 ymzn2024
邮箱 umi@umi6.com

产品

功能总览十大军师岗位技能库产品路线图

解决方案

电子制造连锁餐饮医美机构全部行业

共建

共创共建需求墙灯火计划申请内测

关于

关于我们客户案例行业资讯定价方案常见问题
© 2026 深圳优秘智能科技有限公司粤ICP备2023094291号-1 · 隐私政策 · 服务条款