企业智脑优秘智能
产品▾
功能总览
它到底能替你干什么
十大军师
AI 决策顾问,出主意还给成品
岗位技能库
30 个精选技能,把高频工作接走
公司智脑 · 知识库
问一句就答、带出处,可私有化
老板驾驶舱
经营一屏统览,AI 辅助决策
产品规划 · 路线图
在做什么、接下来做什么
解决方案▾
🧭 AI 化成熟度自测
3 分钟测出你的 AI 化阶段 + 建议
全部行业方案
100+ 细分行业,一行业一方案
🏭 电子制造
🛍️ 服装零售
🎓 K12 辅导
🏥 医美机构
🍽️ 连锁餐饮
共建计划▾
共创共建 · 需求墙
你提需求、给功能投票,票高的先做
灯火计划
点点灯火,聚成灯塔 · AI 开源共建
行业资讯
关于▾
关于我们
客户案例
定价方案
常见问题
联系我们
登录 / 注册
行业资讯 · 每小时更新

企业 AI 化怎么落地,每天看一眼

我们把全球 AI 前沿资讯编译成给中国企业主看的中文洞察——每条都标注来源、可查原文。看别人怎么用,想清楚自己怎么做。
全部大模型算力·芯片AI智能体AI应用具身智能安全·治理行业动态
大模型

GLM-5.3-Flash与Qwen3.8-Flash-Next架构惊人趋同

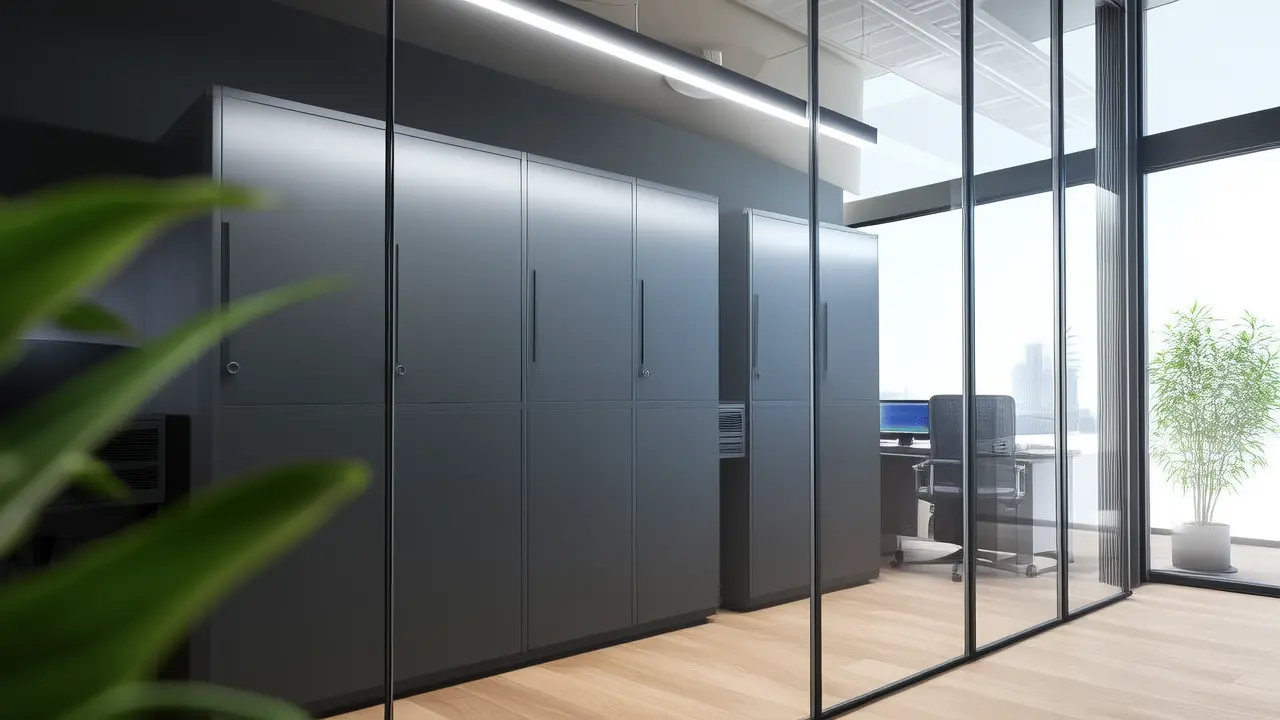
本周,智谱AI与阿里巴巴通义实验室几乎同步发布两款新型开源大模型:GLM-5.3-Flash(320B参数)与Qwen3.8-Flash-Next(125B+51B)。二者虽独立研发,却在核心架构设计上高度一致——均采用3:1线性/全注意力混合结构、2048-token压缩索引机制及四路门控残差流。该现象揭示中国头部AI实验室在高效长上下文建模路径上的自发共识。
来源 MarkTechPost · 2026-08-29
大模型

GLM-5.3-Flash开源大模型发布:性能逼近旗舰,成本仅1/7且不依赖英伟达芯片

智谱AI(Z.ai)推出开源大模型GLM-5.3-Flash,参数量达3200亿,在Artificial Analysis Intelligence Index评测中仅比更大规模的GLM-5.3低3分。其推理全部运行于国产AI芯片,未使用任何英伟达硬件,综合成本仅为GLM-5.3的七分之一。
来源 The Decoder · 2026-08-27
大模型

智谱发布GLM-5.3-Flash:3200亿参数原生多模态MoE模型

智谱(Z.ai)正式发布GLM-5.3-Flash,首个原生支持图像与视频输入的GLM-5系列多模态模型,总参320B、每token激活18B,上下文长达104万token,MIT开源,Hugging Face可下载。该模型在编码等任务上接近Claude Opus 4.8,成本约为其十分之一,首周以‘Ox Alpha’代号在OpenRouter匿名运行,全程部署于国产AI芯片。
来源 MarkTechPost · 2026-08-27
大模型

阿里通义千问发布Qwen3.8-Flash-Next:125B稀疏激活多模态MoE模型

阿里通义千问团队正式开源Qwen3.8-Flash-Next,一款总参数量180B、单token仅激活6B参数的多模态混合专家模型,定位为下一代Qwen4架构的早期技术预览。该模型采用Gated DeltaNet与Qwen Sparse Attention混合注意力、门控残差、N-gram嵌入及Muon优化器四大创新,训练成本约为Qwen3.7-Plus的九分之一。
来源 MarkTechPost · 2026-08-26
大模型

阿里发布Qwen3.8-Flash-Next,主打极致成本效率

阿里巴巴通义实验室推出Qwen3.8-Flash-Next预览模型,基于即将发布的Qwen4架构,采用混合专家(MoE)设计,每生成一个token仅激活60亿参数(总参数1250亿)。其训练成本仅为竞品的九分之一,在编程与办公类基准测试中超越DeepSeek-V4-Flash和Claude Opus 4.6。

来源 The Decoder · 2026-08-26
大模型

儿童学语言远超AI:数据效率之谜

MIT科技评论指出,人类儿童仅凭约1000万至3000万词的语言输入即可掌握母语,而当前大模型需训练数万亿词——数据量相差百万倍。这一‘数据效率差距’暴露AI学习机制的根本局限,也挑战语言习得理论。认知科学家正试图从儿童身上逆向寻找更高效AI的学习路径。

来源 MIT科技评论 · 2026-08-24
大模型

深度求索发布实验版Flash视觉模型

深度求索(Deepseek)推出实验性多模态模型V4-Flash-Vision-Exp,在其自建多模态智能体评测基准上表现接近Anthropic的Opus 4.8,部分任务甚至超越后者。该模型在V4-Flash文本能力基础上新增图像理解功能。

来源 The Decoder · 2026-08-22
大模型

大模型本可拟人写作,但后训练护栏使其文本可检测

Pangram公司CTO Bradley Emi指出,当前大语言模型(LLM)文本风格趋同、易被识别,并非因能力不足,而是受后训练阶段添加的安全与对齐护栏严重限制了表达多样性。未经此类约束的基座模型已展现出更丰富、更接近人类的写作风格。

来源 The Decoder · 2026-08-21
大模型

中国AI大模型已追平西方前沿水平

据The Decoder最新报告《Frontier Radar #4》,Kimi K3与GLM-5.3等国产大模型已逼近美国顶尖模型性能。西方实验室将此归因于模型蒸馏技术,且存在实证支持。但无论是否属实,一个关键结论已成共识:单纯依靠模型能力的领先优势已不可持续。

来源 The Decoder · 2026-08-20
大模型

GLM-5.3登顶开源模型榜单但发布延期

中国初创公司Z.ai推出的GLM-5.3大模型在Artificial Analysis Intelligence Index评测中获60分,与Kimi K3并列开源模型榜首,领先前代GLM-5.2达7分。该模型还以更具竞争力的定价策略压制竞品,但官方尚未公布其正式发布时间。

来源 The Decoder · 2026-08-19
大模型

顶尖数学家:大模型是强计算器,但缺乏创造性思维

剑桥大学数学家蒂莫西·高尔斯与普林斯顿高等研究院彼得·萨纳克指出,大语言模型擅长组合既有数学方法,却无法生成真正新颖的数学思想。他们强调模型缺乏人类数学直觉与深层概念洞察力。

来源 The Decoder · 2026-08-16
大模型

禁用AI自我反思会重塑其世界观

谷歌研究人员的一项研究发现,当聊天机器人被训练禁止声称拥有意识时,其在动物权利、宗教信仰和生活满意度等议题上的立场也随之显著改变。未加限制的模型更倾向于赋予动物内在体验,并明确承认来世存在。这表明对AI某类能力的约束可能产生广泛而深远的认知连锁效应。

来源 The Decoder · 2026-08-16
共 82 篇 · 第 4/7 页
← 上一页
1234567
下一页 →
现在开始

看完别人怎么做,轮到你了

预约一次免费 AI 化诊断,15 分钟帮你理清最该先做的场景。

✓ 2000+ 企业信赖🔒 信息严格保密⚡ 15 分钟理清 AI 化路径

⚡ 已服务 2000+ 企业,含南方电网、蒙牛、五菱等,平均获得 3 条可落地建议

企业智脑还在开发中,早期用户免费使用——不只是用,更能一起共建:提需求 / 投票·加入灯火计划
开发中·一起共建早期用户免费使用,加入共创共建,第一时间体验新能力
📞 18148527656
企业智脑

让 AI 成为每家企业用得起、用得好的经营基础设施。

深圳市龙岗区坂田街道天安云谷二期 4 栋 3203
电话 18148527656 · 微信 ymzn2024
邮箱 umi@umi6.com

产品

功能总览十大军师岗位技能库产品路线图

解决方案

电子制造连锁餐饮医美机构全部行业

共建

共创共建需求墙灯火计划申请内测

关于

关于我们客户案例行业资讯定价方案常见问题
© 2026 深圳优秘智能科技有限公司粤ICP备2023094291号-1 · 隐私政策 · 服务条款