企业 AI 化怎么落地,每天看一眼
我们把全球 AI 前沿资讯编译成给中国企业主看的中文洞察——每条都标注来源、可查原文。看别人怎么用,想清楚自己怎么做。
字节跳动正研发中国最大AI大模型
据《金融时报》报道,字节跳动正在训练参数量高达10万亿的AI大模型,规模为当前中国最大模型——月之暗面Kimi K3的三倍。该模型尚未命名,亦未公布发布时间与技术细节。
DeepMind WeatherNext可更早预测飓风
DeepMind发布WeatherNext气象大模型,称其能比现有方法更早、更准确地预测飓风路径与强度。该模型基于低分辨率气象数据运行,技术原理尚不完全明确。模型将开源。
通义千问Qwen3.8 Max追平Claude Opus 4.8
阿里通义千问Qwen3.8 Max在人工分析智能指数(Artificial Analysis Intelligence Index)中得分为56,较前代Qwen3.7 Max(46分)提升10分,追平Claude Opus 4.8。但月之暗面Kimi K3仍以更高分领先,且成本低25%。
Meta推Muse Spark 1.2与Muse Code,以低价切入开源模型市场
Meta发布Muse Spark 1.2大模型及配套编码智能体Muse Code,后者支持崩溃后断点续执行。其最低档定价低至每百万输出token仅0.2美元,但要求用户共享数据用于训练。此举标志着Meta正以价格而非顶级性能为竞争焦点,而该模型在主流基准测试中存在明显短板。
MiniMax H3成首个登顶AI视频榜单的开源模型
中国公司MiniMax正式开源其H3视频生成模型权重。这是首个在主流AI视频能力排行榜中位列第一的开源模型,标志着开源视频模型首次实现性能领先。
阿里开源旗舰模型Qwen3.8-Max,参数达2.4万亿
阿里巴巴发布新旗舰大模型Qwen3.8-Max,专为处理需持续数日的长周期AI任务设计,如复现科研论文、自主芯片设计等。模型权重计划于下周开源。该模型参数量达2.4万亿,属当前公开披露的最大规模开源模型之一。
阿里千问发布Qwen3.8-Max:2.4万亿参数MoE大模型
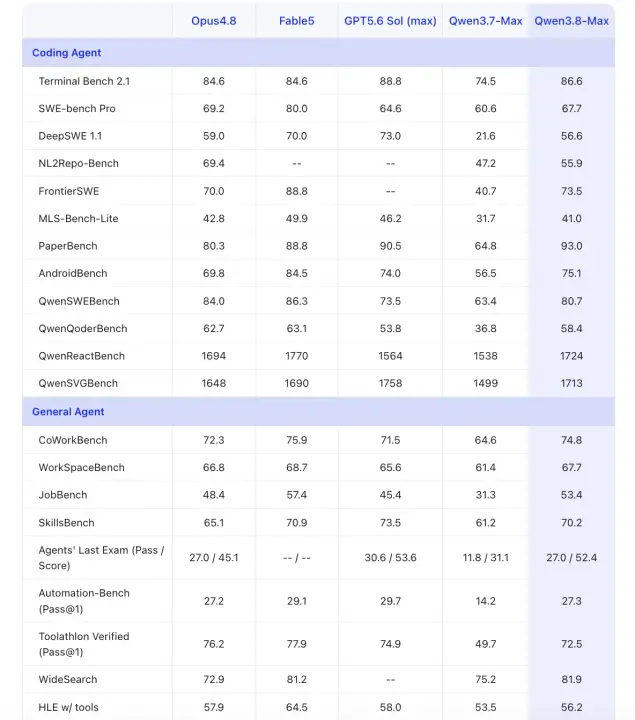
阿里巴巴千问团队正式开放Qwen3.8-Max模型API服务,并宣布其开源权重将于下周发布。该模型为2.4万亿参数混合专家(MoE)架构,支持文本、图像与视频多模态输入,输出为文本;同时同步开放轻量级版本Qwen3.8-27B。官方未披露激活参数量,当前仅Qwen3.8-27B适配常规本地GPU部署。
AMD发布全开源MoE大模型Instella-MoE-16B-A3B
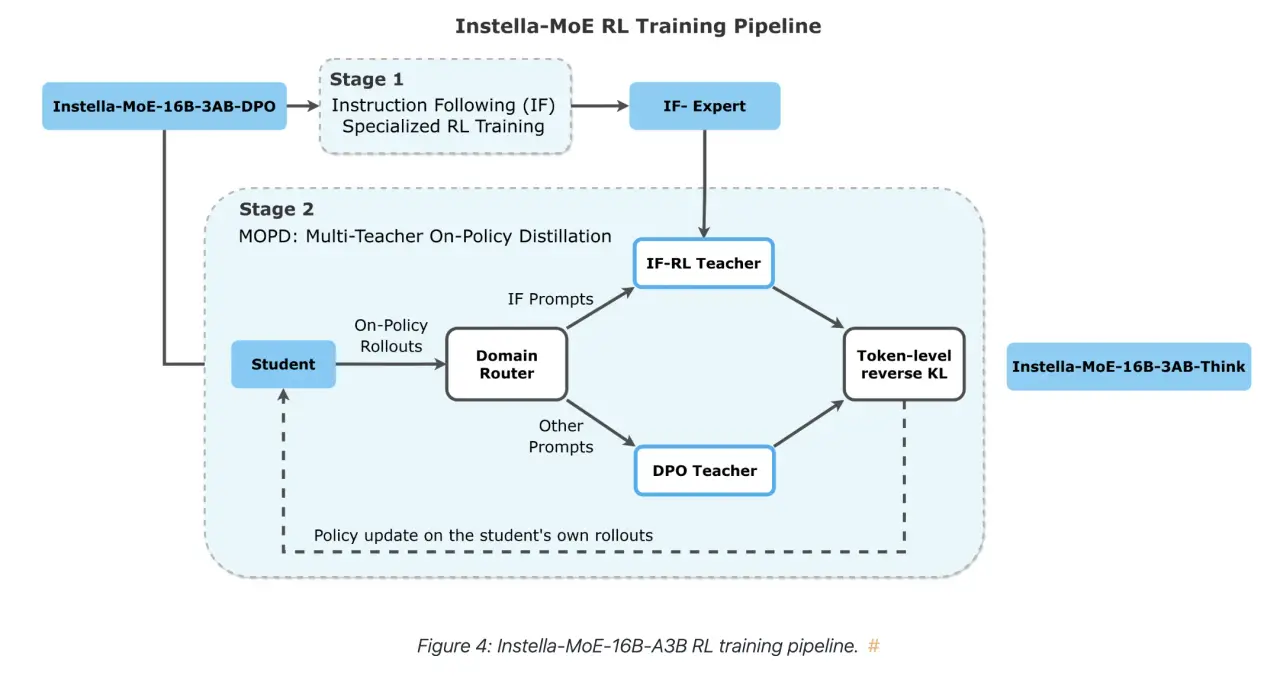
AMD正式发布全开源混合专家语言模型Instella-MoE-16B-A3B,总参数160亿、单次推理激活28亿,全程基于Instinct MI300X/MI325X GPU训练。模型权重采用ResearchRAIL许可(限学术研究),训练代码MIT开源,并集成Gated MLA与FarSkip-Collective两项系统级创新以提升训练与推理效率。
Thinking Machines发布轻量级推理模型Inkling Small
前OpenAI首席技术官Mira Murati创立的AI实验室Thinking Machines推出第二款模型Inkling Small。该开源权重推理模型体积不足原版Inkling的三分之一,却在多项编程与推理基准测试中表现更优。
Deepseek V4 Flash升级后逼近GPT-5.6 Luna
Deepseek发布V4 Flash模型“0731”更新,其在Artificial Analysis Intelligence Index评测中得分提升10分至50分,仅比OpenAI的GPT-5.6 Luna低1分,但单任务成本约为后者的40%。该升级显著提升了该预算型模型的性价比。
语言模型难引科学革命,世界模型或有潜力
Google DeepMind研究员Tom Zahavy在题为《LLMs can't jump》的立场论文中指出,大语言模型缺乏催生真正创新所需的认知机制,因而无法引发科学革命。他提出,更具物理与因果理解能力的‘世界模型’可能具备这一潜力。
OpenAI称GPT-5.6 Sol在ARC-AGI-3测试中胜过Opus 5,但仅限自建测试环境
OpenAI宣称其新模型GPT-5.6 Sol在ARC-AGI-3基准测试中得分38.3%,超越Anthropic的Claude Opus 5(30.2%)。但该成绩仅在其定制API环境下达成,依赖保留推理链与上下文压缩技术;在官方标准测试环境中,GPT-5.6 Sol得分仅为7.8%。